
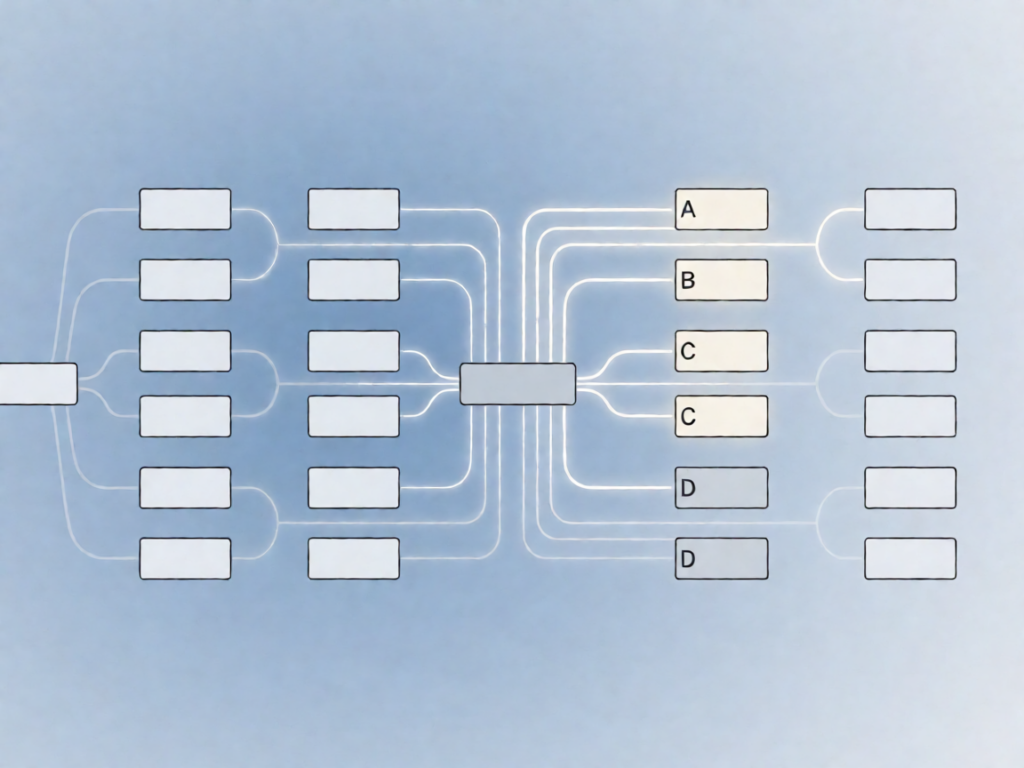
MoE(Mixture of Experts)通过门控网络实现稀疏激活,将输入token路由至少数专家网络处理,实现参数规模与单次计算成本解耦。本文深入解析门控机制的数学原理、负载均衡工程难点、业界落地案例及架构选型判断标准。
核心结论:稀疏激活是突破算力瓶颈的有效路径
Mixture of Experts(MoE)的核心不是堆砌更多参数,而是让每个输入只激活极少部分参数。传统稠密Transformer每次前向传播都要计算全部权重,MoE通过门控网络(Gate Network)将计算集中在少数专家上,参数量可以扩大数十倍,但单次推理的成本基本不变。这让模型规模的扩展不再完全依赖算力的线性增长。
这一思路并非新鲜事——专家混合的概念最早出现在1990年代的统计学习论文中,只是直到Transformer架构成熟、GPU集群普及后,才在大语言模型领域获得实质性落地。关键在于,稠密模型的Scaling Law告诉我们:更大的模型通常带来更好的效果,但代价是算力消耗同步放大。MoE提供了一个不同的增长曲线。
关键判断:MoE的价值不在于让模型”更好”,而在于让模型在”更大”的同时不变得更”慢”和更”贵”。它的目标函数是参数规模与计算成本之间的解耦。
稠密模型的规模困境:参数增长追上算力增长
算力墙与内存墙的双重挤压
训练一个千亿参数模型时,显存占用、通信开销和能耗都在指数级增长。以标准稠密Transformer为例,推理阶段的内存访问成本往往高于计算本身——这就是所谓的”内存墙”问题。模型越大,带宽压力越严重,算力投入的边际回报却在递减。
与此同时,推理成本直接决定了模型能否普惠。当一个模型的单次推理需要数美元时,它只能服务于头部客户,无法形成大规模应用生态。这正是产业界急于寻找更高效架构的深层原因。
Scaling Law的边际效益递减
稠密模型的扩展规律虽然被反复验证,但每次翻倍参数所换取的性能提升幅度在缩小。要达到相同的下游效果,投入产出比越来越不理想。MoE试图用另一种方式延续扩展红利——不是让所有参数都参与计算,而是让参数总量增长的同时,保持每次计算的参数量恒定。
| 模型类型 | 典型参数规模 | 单次推理有效计算量 | 适用场景 |
|---|---|---|---|
| 稠密模型 | 7B~70B | 全量参数 | 低延迟推理、部署简便 |
| MoE模型 | 50B~500B(总) | 2~4个专家 | 高知识密度、大规模应用 |
参数效率的量化对比
以PaLM-E为例,其总参数规模达5620亿,但单次推理只激活280亿参数的专家。这相当于用5620亿参数的知识库,完成了280亿参数模型的推理效率。参数效率比达到20:1,这是稠密模型难以企及的数字。
原理机制:门控网络的路由决策与稀疏激活
门控网络的AI决策本质
MoE的核心组件是一个门控网络(Gate Network)。给定输入token,门控网络输出一个概率分布,表示该token应该被分配给哪些专家。这个门控过程本质上是一个AI决策系统——通过学习到的路由权重,模型自主判断”这个输入最适合哪个专家处理”。门控网络采用Softmax函数输出专家选择概率,并在推理阶段保留top-K个最大概率的专家,其余专家对该token的贡献设为零。
以top-2路由为例,每个token同时由两个专家处理,最终结果加权求和。这意味着模型总参数可以非常庞大,但每个token实际经过的计算路径始终只有少数几条。参数量乘以激活比例,得到有效计算量远低于总参数量。
稀疏激活的计算优势
假设一个MoE模型有64个专家,每个专家含100亿参数,总参数量达到6.4万亿。但每次推理只激活其中2个专家,有效计算量仅为200亿参数。对比同等参数量的稠密模型,MoE在吞吐量和显存占用上具有显著优势。这种架构让大模型部署到资源受限环境成为可能。
- 总参数量决定模型容量上限,影响知识存储能力——MoE可通过增加专家数量持续扩大容量
- 稀疏激活决定单次计算成本,影响推理速度和能耗——激活比例越低,推理效率越高
- 专家数量与稀疏比例之间存在工程权衡,过多专家会放大路由开销和通信延迟
- 门控网络的训练需要额外监督信号,否则容易陷入路由崩溃陷阱
路由选择与知识分工的协同机制
MoE的成功依赖于两个关键机制的协同:一是门控网络学会”识别输入特征并选择合适专家”,二是不同专家通过训练形成”知识分工”。理想的MoE架构中,专家A擅长数学推理,专家B精通代码生成,专家C专注文本理解。这种分工让模型在保持总容量庞大的同时,实现任务特化的处理效率。
工程实践:负载均衡与路由稳定性优化
MoE最棘手的工程问题是负载均衡。如果门控网络总是选择同一批专家,其他专家就会成为”僵尸”——拥有大量参数却从不被使用。这不仅浪费算力,也阻碍了模型整体能力的提升。
业界常用的缓解策略包括辅助损失函数(Auxiliary Loss),它在训练过程中对专家的选择频率施加惩罚项,迫使路由系统均匀利用所有专家。此外,噪声注入、软路由等变体也在实践中被广泛尝试。这些手段的本质都是在模型性能与资源利用效率之间寻找最优解。
负载均衡的核心技术路线
- 辅助损失(Auxiliary Loss):在训练目标中加入专家选择频率的均匀性约束,直接惩罚路由偏好某几个专家的行为
- 噪声注入:在门控网络的输入中加入高斯噪声,打破路由的确定性,促进专家探索
- 软路由(Soft Router):放弃硬性的top-K选择,允许所有专家按比例贡献,降低路由冲突
- 容量因子调整:限制每个专家单次能处理的最大token数,防止过载专家成为瓶颈
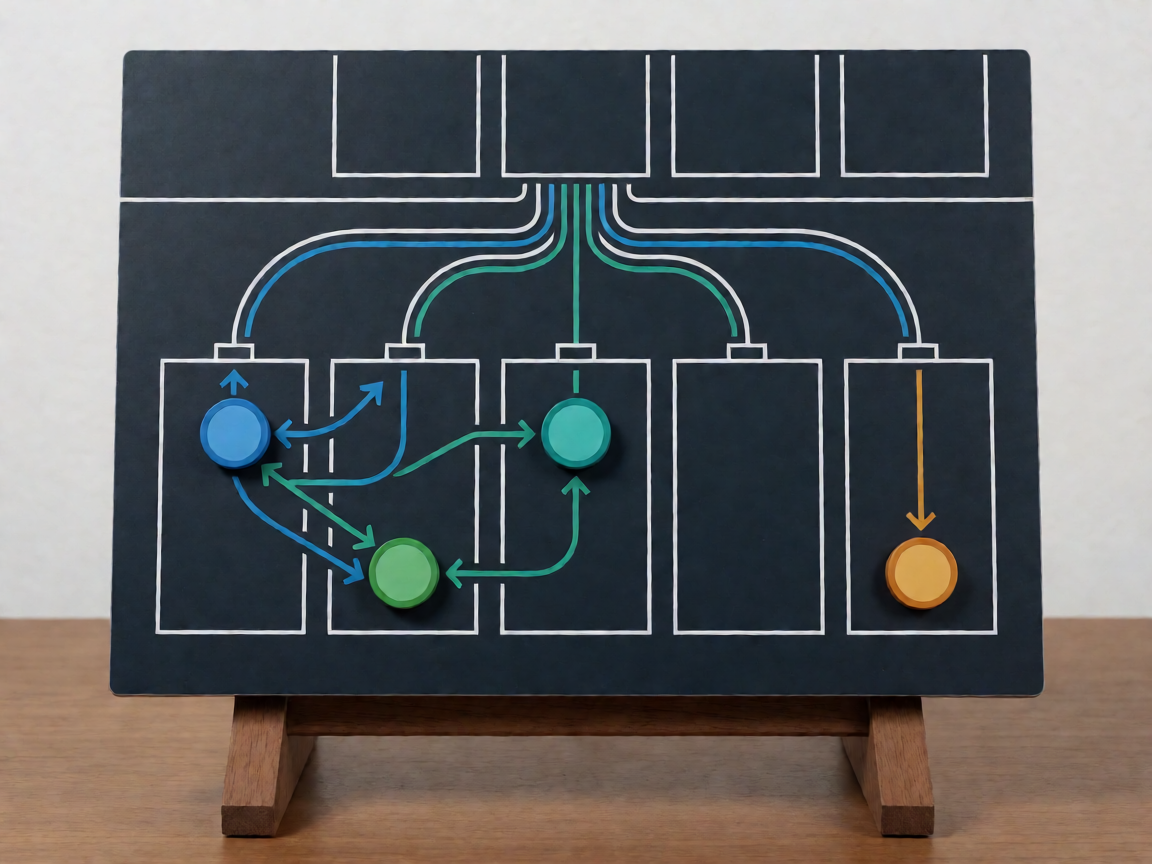
路由稳定性的监控指标
实际部署MoE模型时,需要持续监控以下指标以确保系统稳定运行:各专家激活频率的基尼系数(衡量负载不均程度)、路由熵值(衡量选择多样性)、专家输出方差(衡量知识分工明确度)。当基尼系数超过0.3或路由熵值显著下降时,应触发负载均衡策略调整。
注意:负载均衡是一个持续的研究方向,不同实现方案的效果差异显著。实际部署时需要针对具体场景进行调优,没有通用最优配置。
产业应用:主流MoE模型的落地案例与性能表现
MoE架构近年来在开源社区快速落地,已在多个知名大模型中得到验证和应用。以下是具有代表性的产业案例:
代表性MoE模型及其特点
- GShard(Google, 2020):首个工业级MoE语言模型,64个专家、总参数4560亿,在Wikitext-103上取得突破性成绩,证明了MoE在大规模预训练中的可行性
- Switch Transformer(Google, 2021):采用简化的一跳路由(Single-Hop Routing),仅激活一个专家,大幅降低通信开销,在C4数据集上实现最高效率
- GLaM(Google, 2021):总参数1.6万亿,每次推理激活2600亿参数,推理效率比同等规模的稠密模型快4倍,同时语言建模能力显著提升
- DeepSeek-V2(2024):采用细粒度专家分片(Fine-Grained Expert Splitting)和跨设备负载均衡,在保持推理效率的同时提升了模型容量
- Qwen2.5-MoE(2024):阿里通义千问的MoE版本,14B激活参数+141B总参数,在多个基准测试中超越同级别稠密模型
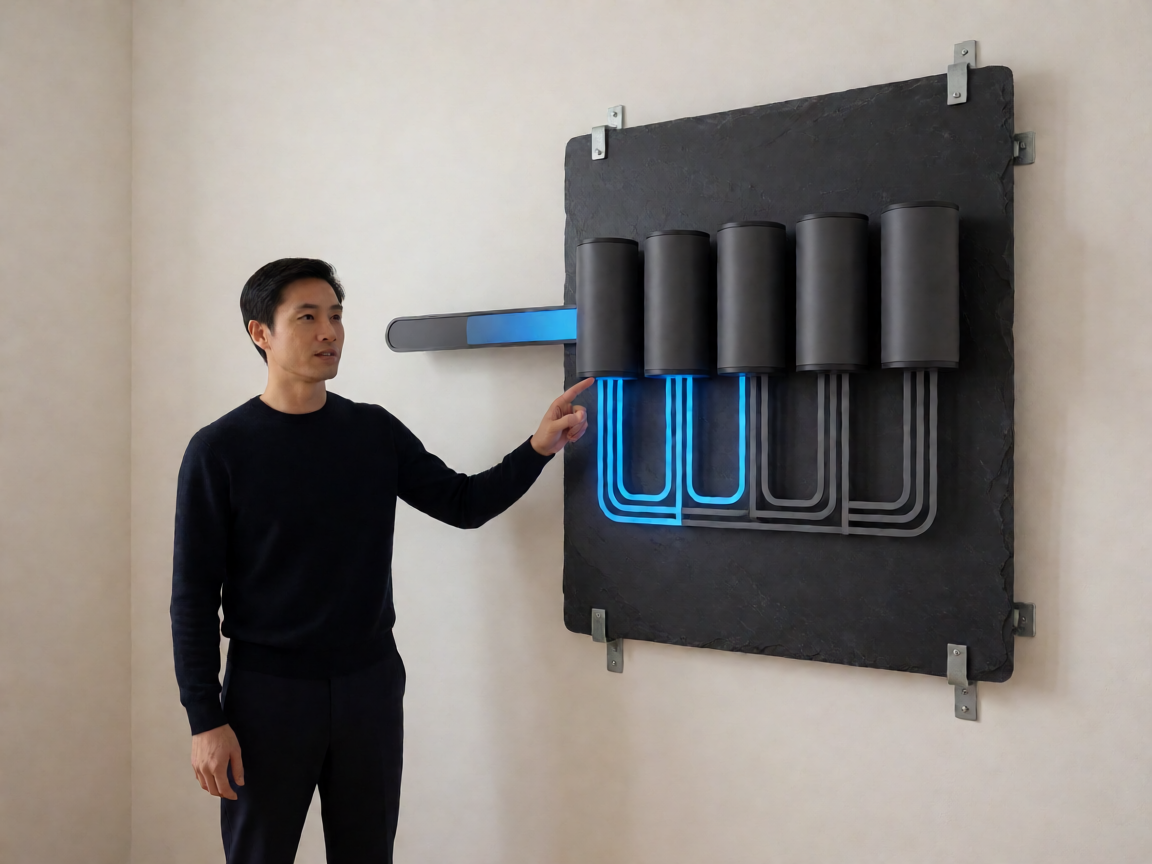
产业应用的关键判断维度
| 评估维度 | MoE优势场景 | 稠密模型优势场景 |
|---|---|---|
| 推理延迟要求 | 中低延迟(专家数量少、计算集中) | 极致低延迟(无路由开销) |
| 算力预算 | 有限算力需要大模型容量 | 充足算力可承受全量计算 |
| 模型部署环境 | 云端GPU集群(专家可分布式部署) | 边缘设备(单一模型权重部署) |
| 知识密度需求 | 需要极高知识储备的复杂任务 | 常规对话、简单推理任务 |
对于开发者而言,选择MoE还是稠密模型取决于具体需求。如果需要极致推理速度且算力充足,稠密模型可能更简单可靠;如果需要更大的模型容量而预算有限,MoE提供了更经济的扩展路径。
开源实现:主流框架的MoE支持现状
当前主流AI训练框架均已原生支持MoE架构,降低了开发者的接入成本:
框架支持的MoE能力对比
- PyTorch DeepSpeed:提供ZeRO-MoE方案,支持专家并行和流水线并行组合,适合大规模分布式训练
- Megatron-LM:NVIDIA维护的MoE实现,支持Tensor Parallel、Pipeline Parallel和Expert Parallel的组合,业界广泛采用
- Unsloth:针对MoE推理优化的轻量级框架,支持动态专家分配和显存自动管理,适合消费级GPU部署
- Transformers(HuggingFace):已集成SwitchTransformer、GLaM等多种MoE变体,便于研究和快速原型开发
开源模型的技术路线差异
不同开源MoE模型在技术实现上存在显著差异:Switch Transformer采用极简的一跳路由,工程实现最简单但负载均衡难度较高;GLaM采用多跳路由(Multi-Hop Routing),每个token经过多层专家处理,能力更强但通信开销更大;DeepSeek-V2引入专家分片(Expert Sharding),将单个大专家拆分为多个小专家并行处理,在效率和容量之间取得平衡。开发者应根据具体需求和硬件条件选择合适的技术路线。
局限与风险:路由崩溃、调试困境与工程挑战
MoE并非完美方案。路由崩溃(Router Collapse)是最典型的故障模式——门控网络在训练中逐渐收敛到固定选择少数几个专家,其余专家被永久闲置。一旦发生这种情况,MoE的优势就几乎丧失殆尽。
另一个挑战是调试复杂度。稠密模型的故障通常可以通过观察损失曲线和激活分布来定位,而MoE引入了路由决策这一中间变量,故障可能发生在路由层、专家层或它们的交互过程中。排查时需要同时监控多个维度的指标,包括每个专家的激活频率、路由熵值、专家输出方差等。
| 问题类型 | 表现特征 | 常见缓解手段 | 检测方式 |
|---|---|---|---|
| 路由崩溃 | 少数专家占据绝大部分激活 | 辅助损失、噪声注入、软路由 | 监控激活频率基尼系数 |
| 专家负载不均 | 部分专家过载导致延迟尖峰 | 动态负载均衡、专家裁剪 | 监控单专家处理token数 |
| 路由不稳定 | 同一输入在不同时间选择不同专家 | 温度系数调节、路由正则化 | 计算路由一致性指标 |
| 通信瓶颈 | 多节点间专家数据搬运开销大 | 专家局部化部署、通信压缩 | 监控节点间传输延迟 |
路由崩溃的早期预警信号
在实际训练中,可以通过以下信号判断路由崩溃的发生:(1)某个专家的激活比例持续超过平均值的3倍;(2)路由熵值连续多个训练步出现单调下降;(3)损失曲线的下降速度突然放缓。一旦发现上述信号,应立即调整辅助损失权重或引入噪声注入策略。
后续观察:动态专家分配与未来架构演进
当前MoE研究正朝两个方向发展。一是动态专家分配——让模型根据输入内容自动决定使用多少个专家,而非固定top-K策略。这种方案在简单样本上节省算力,在复杂样本上保证容量。二是专家专业化——通过初始化设计或预训练数据分布,让不同专家天然倾向于处理特定类型的知识或任务。
动态专家分配的技术路径
- 置信度驱动路由:门控网络同时输出专家选择和置信度评分,低于阈值的输入减少激活专家数量
- 任务感知识别:在门控网络中引入任务分类头,根据不同任务类型预设不同的专家集合
- 复杂度自适应:通过输入序列的长度和难度动态调整专家数量,实现计算资源的最优分配
架构演进的长期判断
这些进展的意义在于,MoE正在从一种”参数效率优化手段”演变为一种”结构化知识组织方式”。当模型能够自主决定”遇到什么问题调用什么专家”时,它离真正的模块化智能又近了一步。
判断:MoE不会取代稠密Transformer成为唯一架构,但它为特定场景提供了不可替代的扩展路径。未来更可能的格局是两者并存——稠密模型负责低延迟推理,MoE模型负责复杂任务和知识密度高的场景。随着动态专家分配和路由优化技术的成熟,MoE的应用边界将持续扩大。
总结与行动建议
MoE架构的本质是用空间换时间、用冗余换效率。它通过门控网络实现稀疏激活,让模型规模得以突破稠密计算的硬件约束,同时保持单次推理成本的可控性。工程落地需要解决负载均衡、路由稳定性和调试复杂度等挑战。建议开发者在以下场景优先考虑MoE架构:(1)算力预算有限但需要大模型容量;(2)训练任务涉及多领域知识且希望实现专家专业化分工;(3)推理环境具备多GPU分布式条件。对于研究和探索而言,从Switch Transformer等简化变体入手,逐步理解MoE的核心机制,再向更复杂的架构演进。
以实际结果为准,操作前请核对官网版本、授权和安全提示。
欢迎留下你的观点,成为第一个参与讨论的人。