
传统GPU执行矩阵乘法需要数据在存储器与计算单元之间反复搬运,造成功耗瓶颈。忆阻器通过欧姆定律和基尔霍夫定律在存储阵列内直接完成模拟乘法累加,从根本上改变了AI推理的能效路径。本文解析其物理原理、技术成熟度与真实应用边界。
为什么AI推理正在撞上进能效墙
英伟达H100单卡FP8算力超过1000TOPS,但功耗已达700瓦。这意味着每次推理调用都在消耗大量电能,而其中绝大部分能量并非用于计算本身。
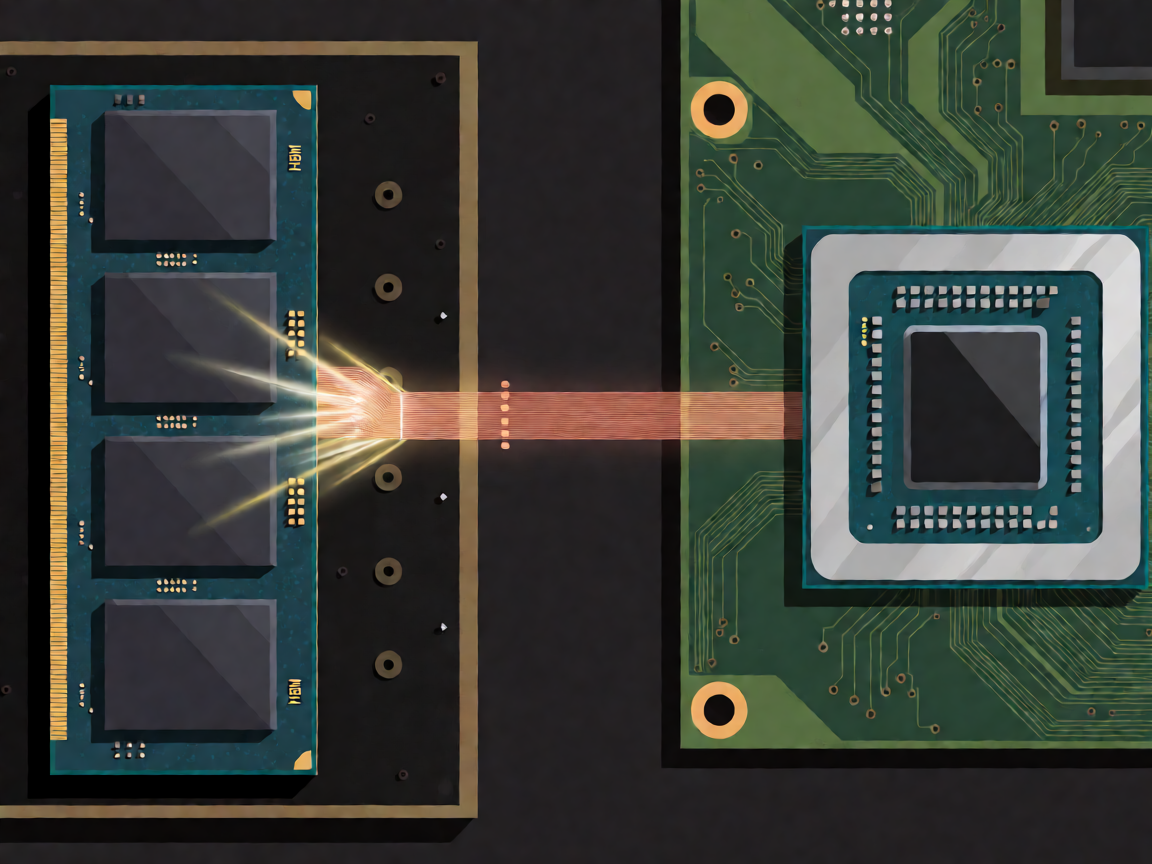
核心问题:GPU在冯·诺依曼架构下,数据必须从HBM显存搬运到SRAM缓存再进入计算单元,往返功耗远高于实际计算功耗。模型越大,瓶颈越严重。
这是一个已被大量研究验证的事实。当模型参数超过显存容量时,还需要跨GPU甚至跨服务器搬运权重,延迟和功耗进一步恶化。边缘部署场景尤其敏感——无人机、手机、物联网设备根本没有冗余功率预算。
业界对这个问题有几种应对路径:更大带宽的HBM4、更高效的网络互联、模型压缩与蒸馏。但它们的共同局限是:依然在冯·诺依曼框架内修修补补,没有改变”存算分离”的根本架构。
忆阻器是什么:从理论预言到实物制造
忆阻器(Memristor)的概念最早由加州大学伯克利分校的蔡少棠教授于1971年提出。他从对称性角度推导:如果电压与电流的关系定义了电阻,电荷与磁通的关系定义了电感,那么电压与电荷、电流与磁通之间也应该存在一种基本元件。
这个元件就是忆阻器——它的电阻值取决于流过它的电荷历史。简单说,它记得自己曾经流过多少电,并据此保持当前的阻态。2008年,惠普实验室在二氧化钛薄膜中首次制备出具有忆阻特性的器件,验证了蔡少棠的预言。
忆阻器的物理结构并不复杂。两端是金属电极,中间夹着一层薄金属氧化物。在电压作用下,氧化物中的氧空位会移动并形成导电细丝,使器件从高阻态(HRS)切换到低阻态(LRS)。撤去电压后,细丝形态保持不变,电阻态得以记忆。
为什么忆阻器天然适合矩阵乘法
神经网络的核心运算是一个巨大的矩阵乘法。数字芯片执行矩阵乘法需要逐行逐列搬运权重数据,而忆阻器可以做到在存储单元内完成乘法运算。
关键机制基于两条经典物理定律:欧姆定律(V = I × R)和基尔霍夫电流定律(节点电流之和为零)。忆阻器交叉阵列的每一行代表一个向量,每一列代表一组权重。当行线施加电压时,流过每个忆阻器的电流大小由电压和阻值的乘积决定。
列线总电流 I_total = Σ(V_row × 1/R_cell)这个求和过程在模拟域内瞬间完成,不需要数字乘法器和累加器的参与。一个N×N的交叉阵列可以一次性完成整个矩阵向量乘法,而FPGA或GPU需要N²次串行乘法累加操作。
能效差异的来源:在跨阵列搬运数据时,每条导线上的电容充放电消耗能量。忆阻器存算一体的核心优势在于消除了”数据移动”这一最大功耗来源,将计算与存储物理位置合一。
技术成熟度:从实验室到流片试产
忆阻器存算一体已经跨越了原理验证阶段,目前处于工程化落地窗口期。全球有多条技术路线并行推进,各自的成熟度差异较大。
| 技术路线 | 代表机构 | 当前状态 | 主要挑战 |
|---|---|---|---|
| ReRAM(阻变存储器) | 三星、SK海力士、Crossbar | 小批量流片 | 器件均匀性与循环寿命 |
| PCM(相变存储器) | 英特尔、美光 | 商用存贮器已量产 | 写入功耗较高,密度受限 |
| FeRAM(铁电存储器) | 富士通、台积电 | 成熟商用 | 集成度低,难以大规模存算一体 |
| 自旋电子器件 | 多家学术团队 | 实验室阶段 | 工艺兼容性待验证 |
三星的ReRAM存算一体芯片已在部分IoT传感器中实现小规模部署,主要用于低功耗模式识别任务。Crossbar公司的ANNA平台则面向更通用的推理场景,声称在Transformer架构上实现了超过传统GPU数十倍的能效比。
但需要客观说明:目前所有公开数据均来自厂商发布或学术论文,缺少独立第三方benchmark的完整验证。学术界对忆阻器阵列的非理想特性(器件噪声、串扰、编程误差)已有充分讨论,这些会在实际系统中显著影响精度。
主流技术路线横向对比
- ReRAM(阻变存储器):与CMOS工艺兼容性最好,开关比高,读写速度较快,是目前商业化进展最快的路线。
- PCM(相变存储器):英特尔与美光已实现商用,但写入功耗较高,且晶态与非晶态之间的转换速度限制了时钟频率。
- FeRAM(铁电存储器):成熟度最高,但集成密度低,难以构建大规模交叉阵列,更适合独立存算而非存算一体。
忆阻器存算一体系列芯片关键指标参考
- 能效上限:Crossbar ANNA平台宣称在Transformer推理中达到每瓦数百TOPS,约比同任务GPU高数十倍。
- 精度约束:模拟计算天然适合8bit及以下精度推理,FP64等高精度场景不适用。
- 面积开销:外围ADC/DAC和校准电路约占总芯片面积的20%-30%,是当前设计优化的重点方向。
真正落地的应用场景在哪里
忆阻器存算一体并非万能解药,它有自己的适用边界。理解边界比盲目乐观更有价值。
- 边缘AI推理:对能耗极度敏感的终端设备,如智能摄像头、可穿戴健康监测器、工业振动传感器。这些场景要求模型在微瓦至毫瓦级功耗下持续运行。
- 近传感器计算:将感知与计算合并在同一封装内,减少传感器数据外传的带宽压力和功耗,在自动驾驶雷达信号处理中有明确需求。
- 事件驱动型任务:与传统”不断采样-不断计算”模式不同,存算一体更适合稀疏触发型计算,只在事件发生时启动处理。
目前不适合的场景包括:需要极高精度(FP64)的科学计算、大规模训练任务、实时视频渲染等需要大显存和复杂控制流的应用。这些领域GPU和专用加速器仍有不可替代的优势。
适用场景判断清单
- ✅ 功耗预算在毫瓦以下,且需要7×24小时持续推理
- ✅ 模型精度在int8/UINT4及以下,可容忍一定量化误差
- ✅ 工作负载以矩阵乘法和卷积为主,控制流简单
- ✅ 数据源为静态传感器或预采集数据,无需大规模回传
- ❌ 需要FP64或BF16精度的科学计算或大模型微调
- ❌ 需要频繁更新权重的在线训练任务
真实风险:器件非理想性与可靠性隐忧
任何新技术从原理到产品都有需要跨越的鸿沟,忆阻器存算一体也不例外。
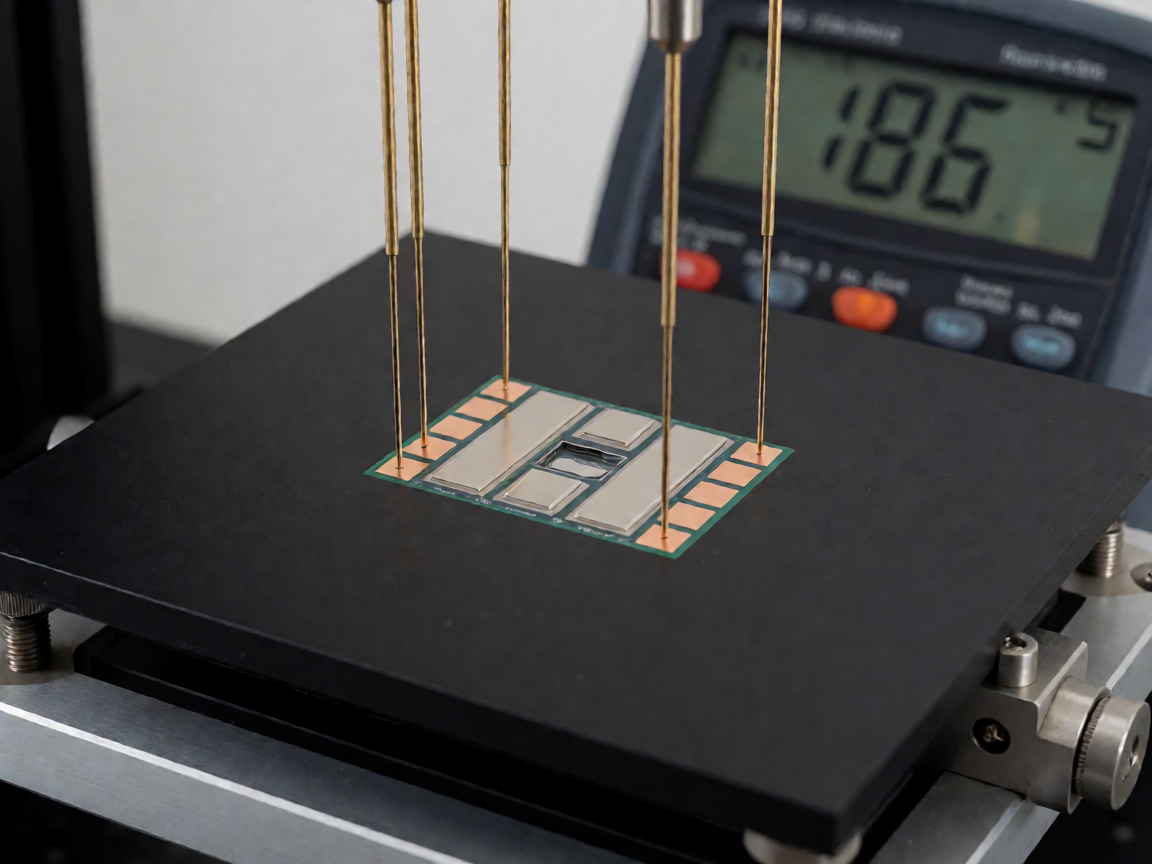
首先是器件的一致性问题。同一批次的忆阻器之间,阻值分布存在显著偏差,这源于制造工艺中导电细丝形成位置的随机性。虽然可以通过校准和容错编码来补偿,但会增加系统复杂度。
其次是循环寿命。ReRAM器件的编程次数通常在10⁶到10¹²次之间,取决于具体材料和结构。对于需要频繁更新权重的训练场景,这个寿命可能成为瓶颈。不过推理场景下的权重更新频率较低,这个问题相对可控。
第三是精度损失。模拟计算的本质是用连续物理量表示数值,而温度漂移、电压波动和器件老化都会引入误差。当前工程方案通常采用混合精度策略:关键层保留数字精度,非关键层使用模拟近似。
一个被低估的风险:存算一体架构对软件栈提出了全新要求。现有主流深度学习框架(PyTorch、TensorFlow)均围绕冯·诺依曼架构设计,移植到存算一体需要重新设计编译器与运行时,这个生态建设远比硬件本身更慢。
三大可靠性风险及缓解措施
- 器件一致性偏差:通过出厂校准表和逐器件阻值映射表进行软件补偿,可将误差控制在可接受范围,但需要额外的存储和计算开销。
- 循环寿命限制:推理场景权重几乎不变,实际编程次数远低于极限;训练场景需采用权重刷新策略,将高频更新层保留在数字区域。
- 模拟精度损失:采用分层混合精度架构,对精度敏感层(如attention层)保留数字路径,对非关键层使用模拟近似,整体精度损失控制在1%-3%以内。
接下来值得关注什么
判断一个技术是否从”有前景”走向”有规模”,有几个关键信号值得跟踪。
第一个信号是标准互连协议的建立。UCIe(Universal Chiplet Interconnect Express)正在为芯片间互联制定开放标准,如果存算一体芯片能纳入UCIe生态,将极大降低系统集成门槛。目前UCIe工作组中已有ReRAM存算一体相关的提案进入讨论阶段。
第二个信号是工具链成熟度。Crossbar、Mythic等公司的编译器工具链正在从原型走向商用版本,如果能在2027年前实现与主流深度学习框架的原生兼容,将是一次重要跃迁。
第三个信号是头部云厂商的采购动作。目前存算一体芯片主要面向边缘市场,如果AWS、Azure或阿里云开始在数据中心内部署存算一体推理节点,将标志着该技术进入了规模化应用的临界点。
总结:存算一体不是颠覆,而是补充
忆阻器存算一体架构的核心价值在于:它在特定场景下提供了超越冯·诺依曼架构的能效上限。这不是通过更快的晶体管或更大的缓存实现的,而是通过从根本上消除数据搬运的功耗来源来实现的。
但它不会取代GPU。两种架构的适用范围有明显分工:GPU擅长高吞吐、高精度、复杂的通用计算;存算一体擅长低功耗、低精度、高度并行的近似计算。未来更可能出现的是异构融合——在同一个系统中同时部署两类计算单元,由编译器自动路由最合适的工作负载。
行动建议:关注UCIe标准进展、跟踪Crossbar和Mythic等公司的工具链版本迭代、留意三星和SK海力士在ReRAM量产工艺上的公告,这三条线索是当前判断该技术落地节奏最有价值的观察窗口。
以实际结果为准,操作前请核对官网版本、授权和安全提示。
欢迎留下你的观点,成为第一个参与讨论的人。