

解析硅光互联技术的核心原理:载流子色散调制、异质集成激光器、锗硅探测器工作机制;梳理CPO共封装光学、板间光互连、芯片级光I/O三大应用路径;评估当前成熟度、功耗优势、成本限制与未来三年技术演进方向。
一、算力瓶颈:从单卡加速到集群通信
过去十年数据中心的进化主线是单卡算力。GPU、TPU等加速器的算力每18个月翻一番,但随之而来的通信压力被长期低估。当集群规模从数百节点扩展到数万节点时,节点间的通信延迟和功耗成为制约整体效率的首要因素。
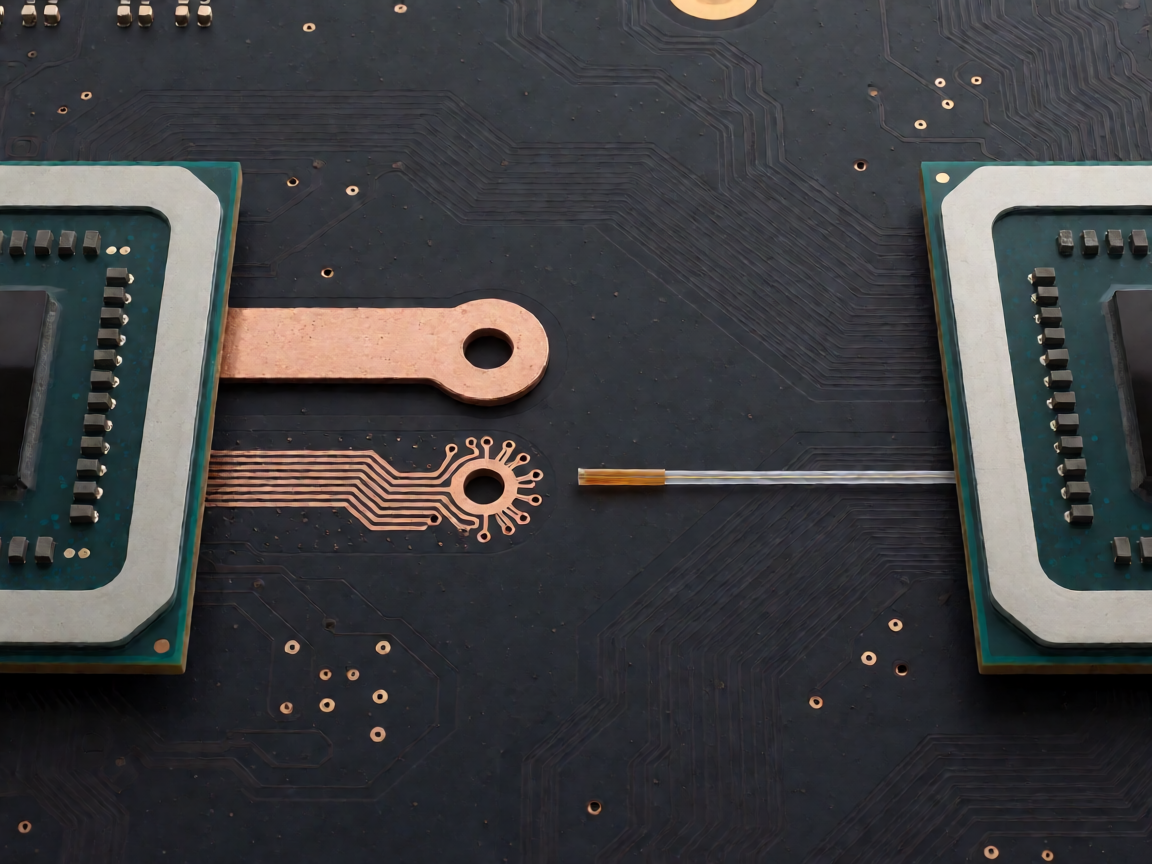
电互连的核心瓶颈在于皮肤效应和介质损耗。随着信号频率升高,电流趋向导体表面流动,有效截面缩小,电阻增大。此外,铜线的介电损耗随频率平方增长,使得长距离高速传输变得极不经济。
根据行业研究,大规模AI训练集群中通信能耗已占系统总能耗的30%以上,部分场景甚至超过计算本身。电互连的带宽密度正在逼近物理极限,单纯依靠提升电信号速率已难以满足需求。
带宽密度瓶颈:每平方毫米的传输极限
电互连的带宽密度受限于铜线的趋肤效应和介电损耗。在112Gbps PAM4速率下,每英寸铜缆的衰减约10dB,超过3米后信号质量急剧恶化,需要昂贵的前向纠错(FEC)和重传机制。相比之下,硅光链路每平方毫米芯片面积可集成数十个独立波长通道,带宽密度呈数量级优势。
二、光通信原理:硅基光子的独特优势
光通信的基本原理并不复杂:用电信号调制光源,光信号在波导中传播,接收端再转换成电信号。关键在于硅基光子的集成能力——能否把光源、调制器、波导、探测器都做在一块硅片上。
折射率对比:光束缚能力的来源
硅材料折射率约3.5,远高于周围二氧化硅包层(约1.45)。这种高折射率差使得光可以在微米级尺寸的光波导中被牢牢束缚,实现弯曲半径仅几微米的紧凑光路布局,这是其他材料体系难以做到的集成密度。
波分复用的带宽扩展逻辑
波分复用技术让单根光纤同时传输多个波长通道,每个通道独立携带数据,总带宽可达数十Tbps。这是电互连难以企及的维度扩展方式——不需要提高单通道速率,只需要增加波长数量,从而规避高频电信号的损耗难题。
三、硅光芯片三大核心器件
调制器:载流子色散效应实现电光转换
硅光调制器主流采用载流子色散效应。当外加电压改变硅波导中的载流子浓度时,折射率随之变化,从而调制通过的光相位。干涉型结构将相位差转换为光强变化,完成电-光转换。高速调制器已可实现单通道100Gbaud以上的符号速率。
激光器:异质集成是唯一可行路径
硅是间接带隙半导体,无法高效发光。目前商用方案普遍采用异质集成:将III-V族化合物激光器(如InP材料)键合或嫁接在硅片上,通过倒装焊或微转移印刷实现光耦合。这一工艺步骤是硅光芯片量产的主要成本来源之一,也是当前产业攻关的重点方向。
探测器:锗硅光电二极管的性能指标
锗在硅工艺中具有良好的晶格匹配性,可实现高速低噪声的光电探测。吸收区位于锗层,光生载流子在反向偏置下快速漂移形成电流信号。当前商用硅光电探测器的响应度已超过0.6A/W,带宽覆盖40GHz量级,满足主流光模块需求。
四、产业落地的三条应用路径
硅光互联目前主要有三个应用方向:数据中心内部光模块、板间光互连和芯片级光电接口。
- 共封装光学(CPO):Intel推出的E810网卡集成了硅光收发器,支持200Gbps per lane,实现了芯片与光器件的一体化封装。该方案显著降低了多芯片系统的信号完整性设计复杂度,减少PCB走线长度带来的损耗。
- 板间光互连:Cohu等厂商推出了基于硅光技术的OFC光学转接模块,直接替代传统铜排线,在GPU主板之间提供低延迟高带宽连接,适用于交换机芯片与端口板之间的背板替换场景。
- 芯片级光电接口:NVIDIA在NVLink基础上探索光I/O方案,目标是让GPU之间不再依赖铜缆,而是通过硅光链路实现TB级互联。
五、硅光互联的成熟度评估
评估硅光互联产业化成熟度需从三个维度综合判断:技术就绪水平(TRL)、成本竞争力、生态系统配套。
技术就绪水平:CPO处于TRL-7至TRL-8阶段
CPO(共封装光学)是目前进展最快的应用路径。Intel、Broadcom等厂商已完成工程样机验证,预计未来两年内会有更多商用产品进入高端数据中心。但大规模量产的良率控制、热管理方案和封装工艺仍需要时间沉淀。
成本竞争力:硅光模块溢价约30%-50%
硅光模块单价仍高于同等性能的传统光模块约30%至50%。成本高的原因主要来自异质集成激光器的工艺复杂度、耦合对准精度要求以及测试环节的设备投入。随着产能扩大和工艺成熟,预计2026-2027年成本差距将缩小至15%以内。

生态系统配套:测试设备和维护工具链待完善
光互连设备的测试需要高精度光谱仪和光时域反射计,维护人员需要掌握光功率预算、波分复用器插损等专业技能,这部分人才储备目前较为稀缺。

六、对数据中心架构的实际影响
| 互连方式 | 典型功耗 | 带宽密度 | 最大传输距离 |
|---|---|---|---|
| 铜缆电互连 | 10-30 pJ/bit | 受限于信道衰减 | <3米 |
| 硅光互联 | 1-5 pJ/bit | TB级/芯片 | 可达百米级 |
| 传统光纤模块 | 5-15 pJ/bit | 受封装限制 | 可达数公里 |
硅光互联最直接的效果是降低了每个比特的传输能耗。铜线每传输1比特约消耗10至30皮焦耳能量,而硅光链路可降至1至5皮焦耳量级,降幅达一个数量级。
拓扑自由度:全互联架构成为可能
带宽密度的提升让机柜内拓扑可以更灵活。传统电互联受走线阻抗和串扰约束,拓扑形状被大幅压缩;光互联则近乎无视走线空间限制,允许更自由的全互联架构设计,这对分布式训练的效率有实质性改善。
七、现实限制与尚未解决的问题
光交换能效比仍待突破
另一个未被充分解决的问题是光交换的能效比。静态光交换(如MEMS微镜阵列)的切换延迟在毫秒级,无法满足动态流量调度需求;而电-光-电多次转换又抵消了部分节能收益。真正低延迟低功耗的光交换器仍处于实验室阶段。
基础设施改造的隐性成本
现有数据中心基础设施并非为光互联原生设计。线缆管理、散热布局、维护工具链都需要重新规划,这部分隐性成本常被低估。对于中小规模数据中心而言,全面替换为光互联的经济回报周期较长,预计需要5-7年才能收回改造投资。
八、未来三年的关键技术节点
片上激光器集成:成本控制的核心突破口
若能实现硅基激光器的直接生长或异质集成并达到规模化良率,将是成本控制的关键突破,可大幅降低硅光模块的单位成本。
薄膜铌酸锂(TFLN)与硅光的融合趋势
薄膜铌酸锂调制器的集成度优于硅基调制器,且带宽和线性度俱佳,是替代硅基方案的重要竞争者。两种技术路线的融合趋势值得关注,可能催生混合集成新架构。
CPO量产节奏:2026-2027是关键窗口期
Intel、Broadcom等厂商已在CPO领域推进相关标准制定,预计2026-2027年会有更多商用产品进入高端数据中心,届时将验证技术成熟度和成本竞争力。
九、总结与行动建议
硅光互联的本质是用光的带宽优势弥补电的功耗劣势。它不是一个单一产品,而是一套从材料、工艺到系统架构的完整技术栈。当前产业正处于从专用场景向通用场景渗透的关键阶段,成本下降和集成度提升是决定其能否进入主流数据中心的核心变量。
技术决策的三个判断维度
对于关注基础设施的技术决策者而言,硅光互联的价值判断应聚焦于三个维度:单位比特传输成本、延迟稳定性和系统级能效。建议在AI训练集群的GPU-交换机互联场景优先评估CPO方案,在中等规模数据中心暂缓大规模部署,等待成本进一步下降。

后续观察要点
重点关注片上激光器良率突破、CPO标准化进展以及薄膜铌酸锂集成工艺的成熟速度。这三项技术指标将决定硅光互联从高端场景走向主流数据中心的实际时间表。
以实际结果为准,操作前请核对官网版本、授权和安全提示。
欢迎留下你的观点,成为第一个参与讨论的人。