
大模型训练参数量突破万亿级后,传统GPU显存容量成为核心瓶颈。CXL内存池化技术允许跨GPU共享DRAM,Intel、AMD及多家云厂商已推出相关方案。本文解析技术原理、产业进展与真实应用边界。
万亿参数模型逼出显存危机,CXL为何被重新关注
2024年以来,大模型参数规模持续突破万亿级别,GPT-4类模型的训练参数量已远超上一代模型数十倍。模型越大,单个GPU的HBM显存容量越难满足训练时的激活值存储需求,这导致训练集群需要堆叠更多GPU来分摊负载,成本随之直线上升。
传统做法是在GPU内部继续增大HBM容量,但HBM的堆叠层数和带宽提升速度已经跟不上模型规模增长的速度。与此同时,HBM的价格昂贵且产能受限,使得”拼显存”成为AI算力建设中最突出的瓶颈之一。
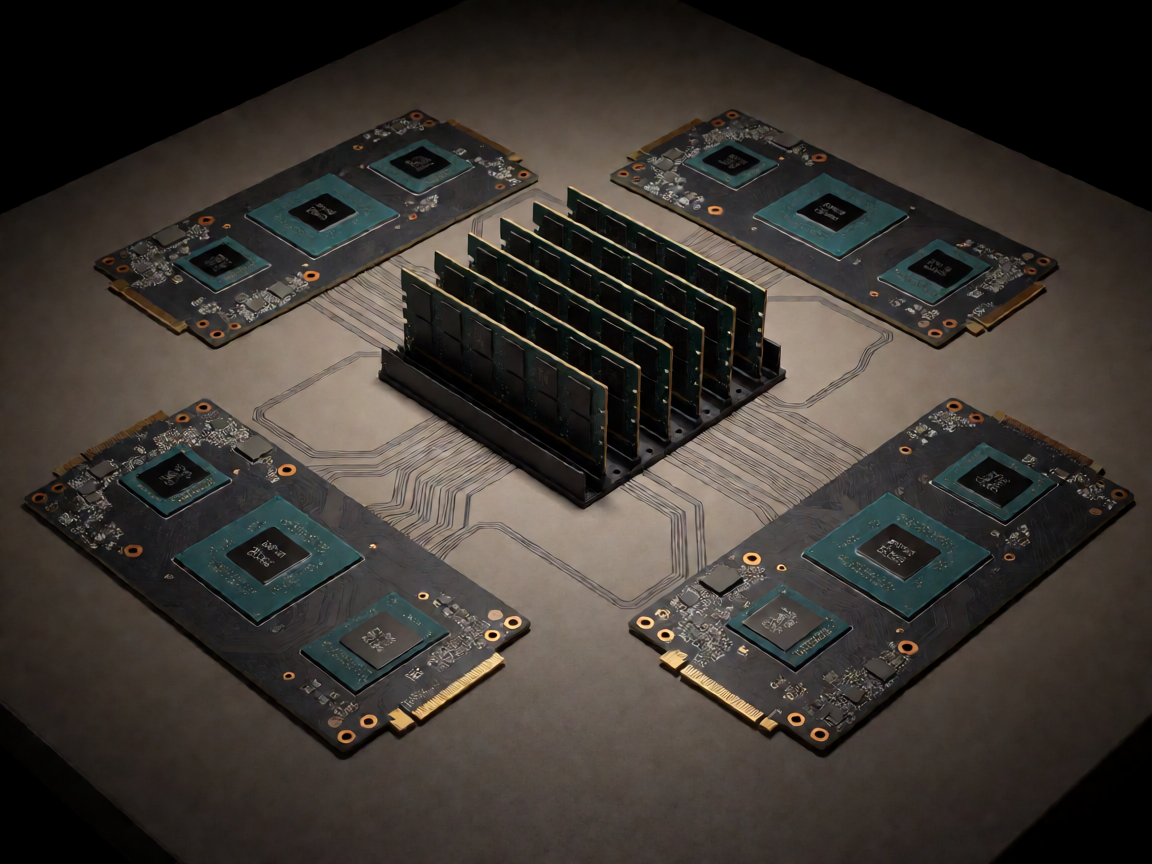
CXL(Compute Express Link)技术原本由Intel主导开发,目标是为CPU和加速器之间提供一种比PCIe更高效的内存互连协议。当GPU不再满足于”只拿自己的HBM”时,CXL内存池化的价值开始显现:它允许一台服务器上的多张GPU共享更大的系统级DRAM池,而不是每张卡都绑定有限的HBM。
核心判断:CXL内存池化并非革命性突破,而是对现有架构的一次务实升级——用相对廉价的DDR5替代部分HBM,换取显存容量的弹性扩展,代价是访问延迟略高。
CXL内存池化的技术原理:如何打破”一张卡一块HBM”的边界
CXL基于PCIe的物理层协议,但在协议栈上层引入了内存语义。与传统PCIe设备只能”看到”CPU地址空间中的内存不同,CXL设备可以直接参与内存的分配和管理,这意味着GPU可以通过CXL总线直接访问连接在CPU侧的大容量DDR5内存池。
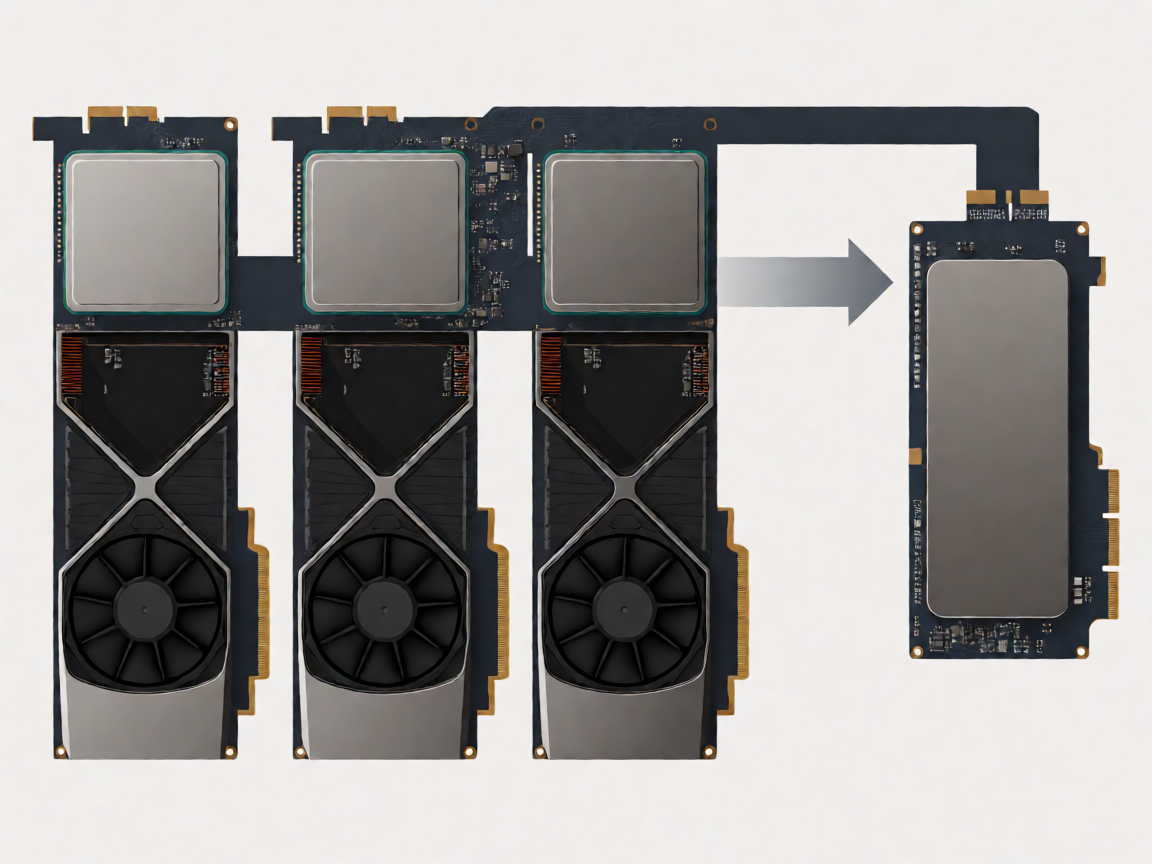
其核心机制是:系统将多张GPU的HBM视为第一层高速缓存,将CXL连接的DDR5内存作为第二层。训练时,关键的热数据留在HBM中快速读写,而大块的激活值、梯度等可以被”溢出”到CXL内存池,避免单卡HBM直接溢出到系统内存造成的性能骤降。
关键机制:CXL支持三种设备类型——CXL Type 1(内存扩展)、CXL Type 2(内存+I/O混合)、CXL Type 3(完全内存设备)。目前AI训练场景主要使用Type 3,即直接将DRAM作为加速器可寻址的内存池。
CXL 1.x与CXL 2.0/3.0的关键差异
- CXL 1.1:仅支持内存共视(coherency),带宽和路由能力有限,主要用于服务器内存扩展。
- CXL 2.0:引入多端口扩展器(Switch),允许更多设备接入,端到端带宽提升至128 GT/s,适合GPU-CXL内存池连接。
- CXL 3.0:在2.0基础上增加多宿主(multi-host)支持,允许多个主机同时访问同一内存池,但硬件和软件成熟度仍在推进中。
对于AI训练场景而言,CXL 2.0是当前最实际的选择——它已经能够在生产环境中稳定运行,而CXL 3.0的多宿主特性更适合未来云原生架构的长期演进。
产业进展:谁在做、做到什么程度
当前量产方案一览
- Intel Gaudi 3:2024年发布,内置CXL内存池化支持,宣称可实现跨节点内存共享,官方数据表明在LLM推理场景中可将有效显存容量扩展约40%,同时降低对纯HBM的依赖。
- AMD MI300X:采用CPU+GPU统一内存架构,虽然不是传统意义上的CXL,但实现了类似的”更大内存池”目标,单卡64GB HBM + 192GB DDR5的统一寻址模式,为后续CXL扩展奠定基础。
- Intel Xeon + CXL内存扩展器:基于Sapphire Rapids和Granite Rapids处理器,配合Xeon Phi协处理器,已在AWS和Azure等云平台提供CXL内存池化实例,主要面向HPC和推理负载。
- Cerebras WSE-3:虽然没有直接使用CXL,但其超大片上内存(96GB SRAM)的方案与CXL内存池化解决的是同一个问题——显存不足,两者代表了不同的技术路线。
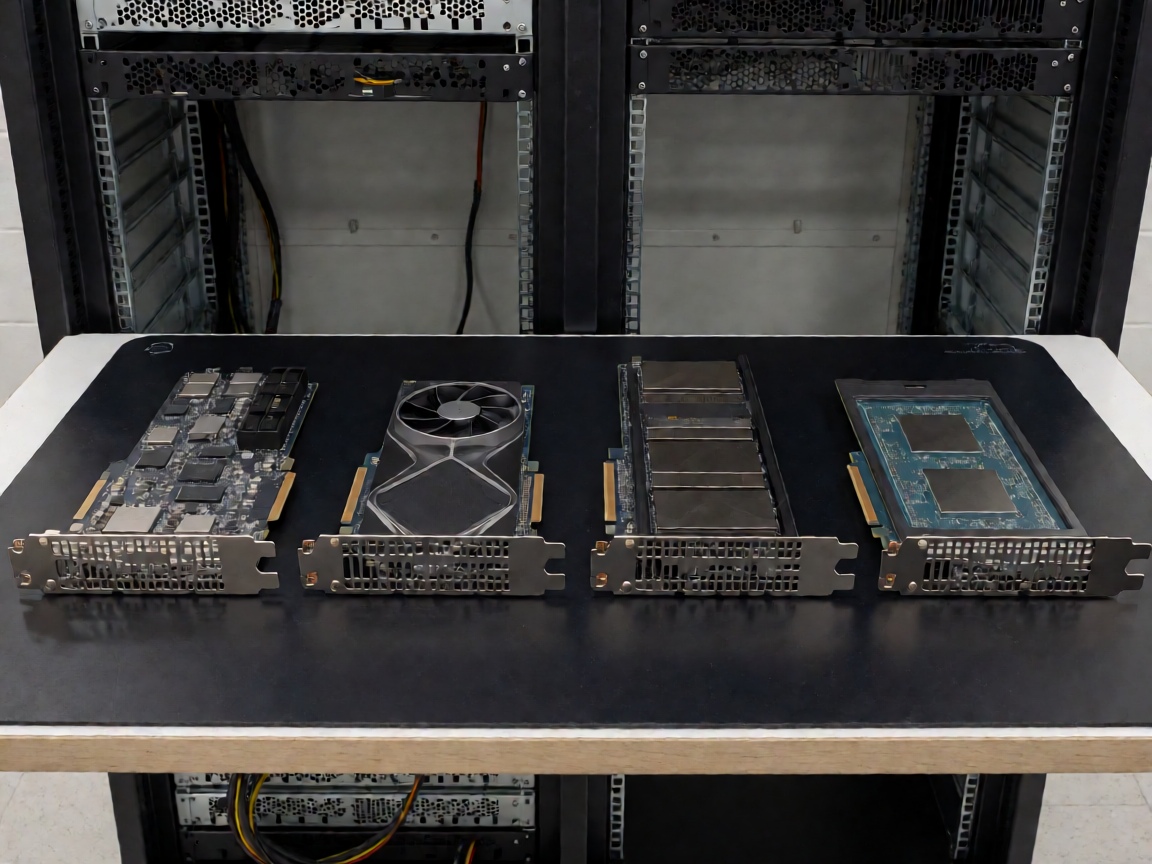
信息边界说明:上述方案中,Intel Gaudi 3和AMD MI300X的CXL相关性能数据来源于厂商发布资料,实际生产环境中的内存扩展效果和延迟影响,因 workload 和调度策略不同而存在差异,具体数据需以各厂商实测报告为准。
云厂商方面,AWS已通过EBR(Elastic Block Store)和EC2实例间接支持CXL内存池化,Azure和Google Cloud也在跟进相关产品发布。这些服务目前主要面向推理场景,训练场景的CXL部署仍处于早期实验阶段。
真实应用场景与性能表现
典型训练任务中的内存节省效果
- LLM预训练:以70B参数模型为例,单卡HBM通常在80GB左右,需要至少8张卡才能完成单卡加载。引入CXL内存池化后,激活值可以溢出到共享DDR5池,理论上可以将最低卡数需求降低至4-6卡,前提是模型调度器能有效管理内存分页。
- LLM推理:推理阶段的内存压力主要来自KV Cache。CXL内存池化允许更大batch size的并发推理,实测数据显示在相同硬件条件下,推理吞吐量可提升20%至40%,具体取决于请求长度和并发模式。
- 微调任务:LoRA等参数高效微调方法的显存占用相对较低,CXL的介入价值不如预训练显著,但在全参数微调场景下仍有明显收益。
重要提示:以上性能数据为基于公开资料的估算范围,实际效果受模型架构、框架实现、内存调度策略等多种因素影响。建议在实际部署前进行针对性基准测试。
成本与效率的计算:值得上吗
CXL内存池化的核心价值在于成本优化。HBM每GB的价格大约是DDR5的5到10倍,且HBM产能增长缓慢。将部分内存需求转移到CXL连接的DDR5上,可以在不牺牲太多性能的前提下,显著降低单卡显存配置的门槛。
从投资回报率角度看,对于训练任务而言,CXL方案的主要收益体现在三个方面:降低单卡HBM配置需求从而减少GPU采购成本、允许现有集群在不更换GPU的情况下扩展内存容量、以及为未来模型规模增长预留弹性。
成本估算参考:以8×H100(80GB HBM)的集群为例,如果引入CXL内存池化后能将部分显存需求转移至DDR5,单卡HBM从80GB降至48GB或更低,预计可降低GPU采购成本约15%至25%。具体数字因配置而异,但方向是明确的。
然而,”便宜”不等于”划算”。CXL内存的访问延迟约为HBM的10倍以上(HBM约100ns,DDR5通过CXL访问约1us级别),如果模型训练频繁访问CXL内存,整体性能可能不升反降。因此,内存调度的智能化程度是关键变量。
局限、风险与争议
- 延迟惩罚:CXL内存访问延迟比HBM高一个数量级,对于内存访问密集型的训练步骤(如注意力机制的前向传播),可能成为性能瓶颈。
- 生态成熟度:操作系统、驱动、框架对CXL内存池化的支持仍在完善中。PyTorch和TensorFlow对CXL的原生支持有限,大多需要自定义内存管理逻辑。
- 调度复杂度:如何智能地将热数据和冷数据分配到HBM和CXL内存池,是一个尚未完全解决的工程问题。错误的调度策略会导致频繁的内存翻页,反而拖慢训练速度。
- 厂商锁定风险:目前CXL内存池化的主流方案由Intel和AMD主导,NVIDIA尚未推出同等规模的CXL内存池化方案,可能导致生态碎片化。
- 可靠性问题:DDR5通过CXL总线传输,相比HBM的芯片级封装,在信号完整性和错误率控制上面临更高要求,生产环境需要更严格的ECC和错误恢复机制。
风险提醒:CXL内存池化在推理场景的表现相对成熟,但在大规模预训练场景中的稳定性和效率仍有待更多生产级验证。建议企业在关键训练任务上线前,先在同类 workload 上进行充分测试。
接下来值得关注什么
CXL内存池化的发展轨迹有以下几个值得关注的节点:一是CXL 3.0标准在各厂商硬件上的落地进度,特别是多宿主支持是否能在2025年内进入生产环境;二是主流深度学习框架对CXL内存的原生支持程度,这决定了普通开发者能否无痛使用;三是NVIDIA是否会在Blackwell架构后续版本中引入CXL内存池化支持,这将是判断该技术能否成为主流的关键信号。
此外,云厂商推出的CXL内存池化实例的实际用户反馈和成本数据,也是评估该技术实用价值的重要依据。目前相关信息仍较零散,建议在Q4至2026年初持续关注各大云服务商的官方公告和第三方基准测试结果。
总结
CXL内存池化是对AI训练显存瓶颈的一次务实回应。它不能替代HBM的高速访问能力,但在内存容量扩展和成本优化方面提供了现有架构之外的可行路径。对于中小型研究机构和预算受限的训练团队而言,CXL方案可能是一个值得尝试的过渡选择;而对于追求极致性能的大型实验室,当前阶段可能仍需要等待更成熟的生态配合。
核心结论:CXL内存池化不会取代HBM,也不会让大模型训练不再需要昂贵的GPU。它更像是一座桥梁——在现有显存架构和无限增长的内存需求之间,提供了一个弹性扩展的中间方案。随着框架支持和调度算法的完善,未来一到两年内有望进入更多生产环境。
后续观察建议:关注Intel Gaudi系列和AMD MI系列的后续迭代中CXL支持的演进,以及PyTorch官方对CXL内存池的原生集成计划。这两个信号将决定CXL内存池化能否从”可选方案”变成”默认选项”。
以实际结果为准,操作前请核对官网版本、授权和安全提示。
欢迎留下你的观点,成为第一个参与讨论的人。