
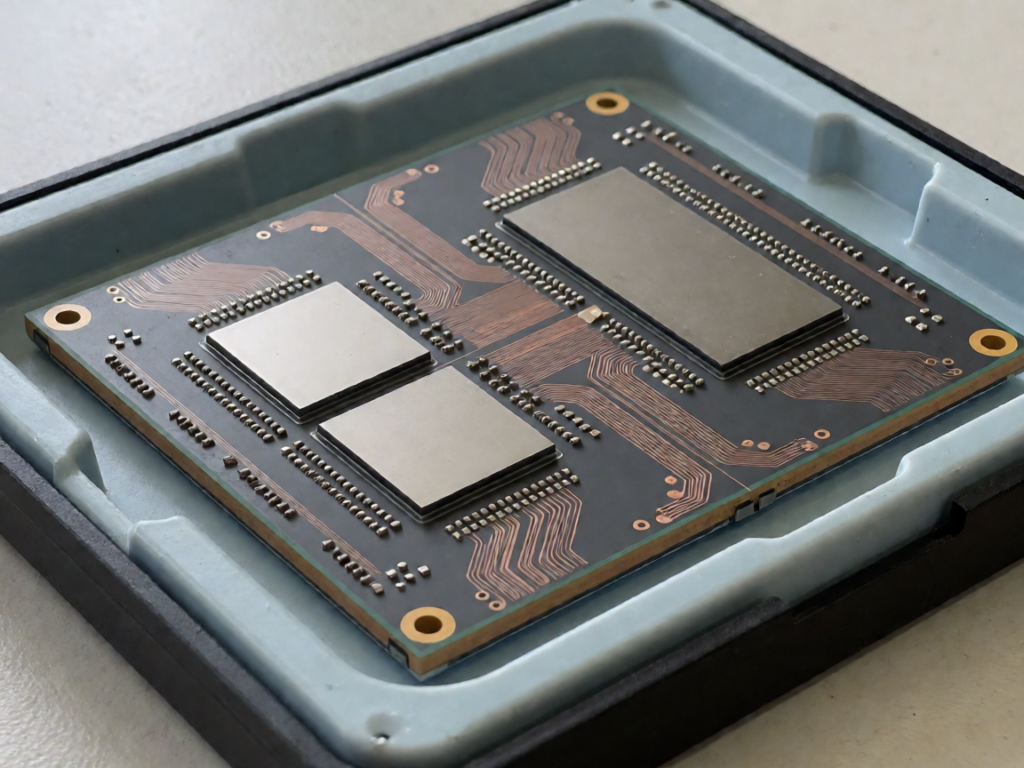
AI集群扩展遇到真正的瓶颈,不是GPU算力,而是数据移动。传统可插拔光模块在800G/1.6T速率下到达物理极限,共封装光学(CPO)将光引擎直接封装在交换芯片旁。本文解释其原理、技术路线分歧、热管理挑战与产业现状。
AI集群的下一个瓶颈,不是算力
一个万卡GPU集群在训练大模型时,每个GPU都要和其他9999个GPU频繁交换梯度数据。NVIDIA H100的理论峰值带宽是3.35TB/s,但实际可用带宽通常只有理论值的60%到70%。这个差距不是GPU本身的问题,而是网络架构在拖后腿。
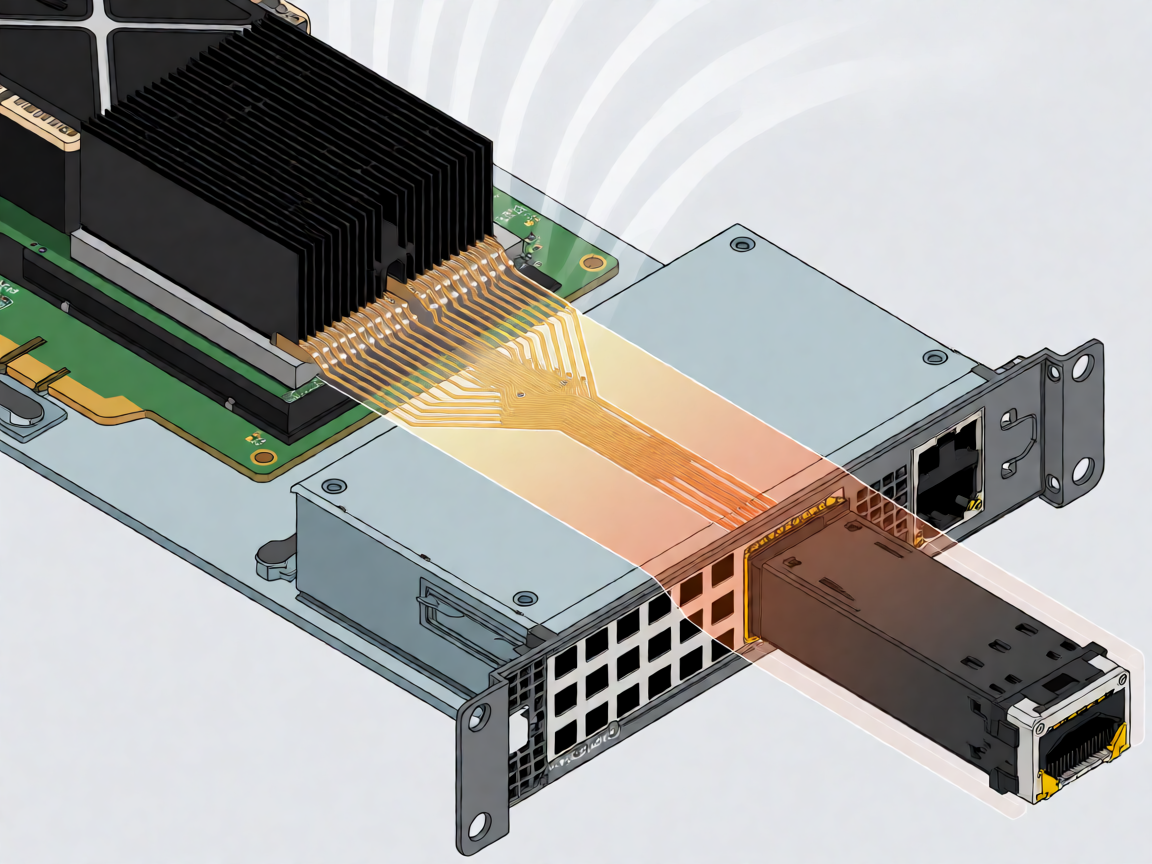
数据中心网络的设计目标是低延迟、高吞吐、确定性——这三者在物理层面存在根本矛盾。传统可插拔光模块在1.6Tbps速率下,信号在铜走线上的损耗已经接近物理极限。当集群规模从数千卡扩展到数万卡时,网络延迟成为训练效率的最大制约因素。
这就是为什么整个数据中心行业正在认真考虑一个架构变更:把光引擎从可插拔模块中解放出来,直接封装在交换芯片旁边。
核心判断:CPO不是对现有方案的改良,而是对’计算+通信’架构的重新划分。它将光信号处理从独立模块下沉到交换芯片封装内部,代价是维护复杂度和散热设计的大幅上升。
可插拔光模块的物理天花板
传统数据中心交换机使用可插拔光模块——比如OSFP或QSFP-DD形态。每个端口集成一个独立的光引擎,通过铜走线连接到交换芯片。这种架构在过去十年一直运转良好,因为带宽增长速度和电信号损耗之间存在一个可以被工程手段弥补的窗口。
但这个窗口正在关闭。在800Gbps及以上速率,铜走线的插入损耗急剧增加。一个典型的OSFP模块通过PCB铜线传输800G信号时,衰减可能达到15dB以上。这意味着每个比特在到达接收端之前已经损失了约97%的能量,接收芯片必须用巨大的功耗来补偿。
| 参数 | 可插拔光模块 | 共封装光学CPO |
|---|---|---|
| 光引擎位置 | 独立模块,可热插拔 | 与交换ASIC同封装 |
| 电互联长度 | 5-10cm PCB走线 | <1mm 基板互联 |
| 单端口功耗预算 | ~50W(含接口损耗) | ~15-20W |
| 带宽密度 | 受限于模块尺寸 | 不受模块形态限制 |
| 维护方式 | 热插拔更换 | 需整体模块更换 |
关键数据来自industry分析:一个800G可插拔光模块的总功耗(激光器+DSP+电接口)已达到约50W,而同等功能的CPO方案理论功耗可以降至15-20W。这不是百分比级别的改进,而是一个数量级的差异。
重要细节:CPO方案的光引擎部分功耗与可插拔模块相近,差异主要来自去掉了长距离电接口所需的DSP芯片和信号调理电路。光信号一旦产生,在近场传输中几乎不需要额外能耗。
共封装光学的原理:把光搬进封装
共封装光学的核心思想很简单:既然铜走线是瓶颈,那就消除它。把光引擎——包括激光器、调制器、光电探测器——直接封装在交换芯片的same substrate上,通过极短的硅光波导或interposer连接,信号以光的形式在亚毫米级距离内传输,完全绕过铜走线损耗问题。
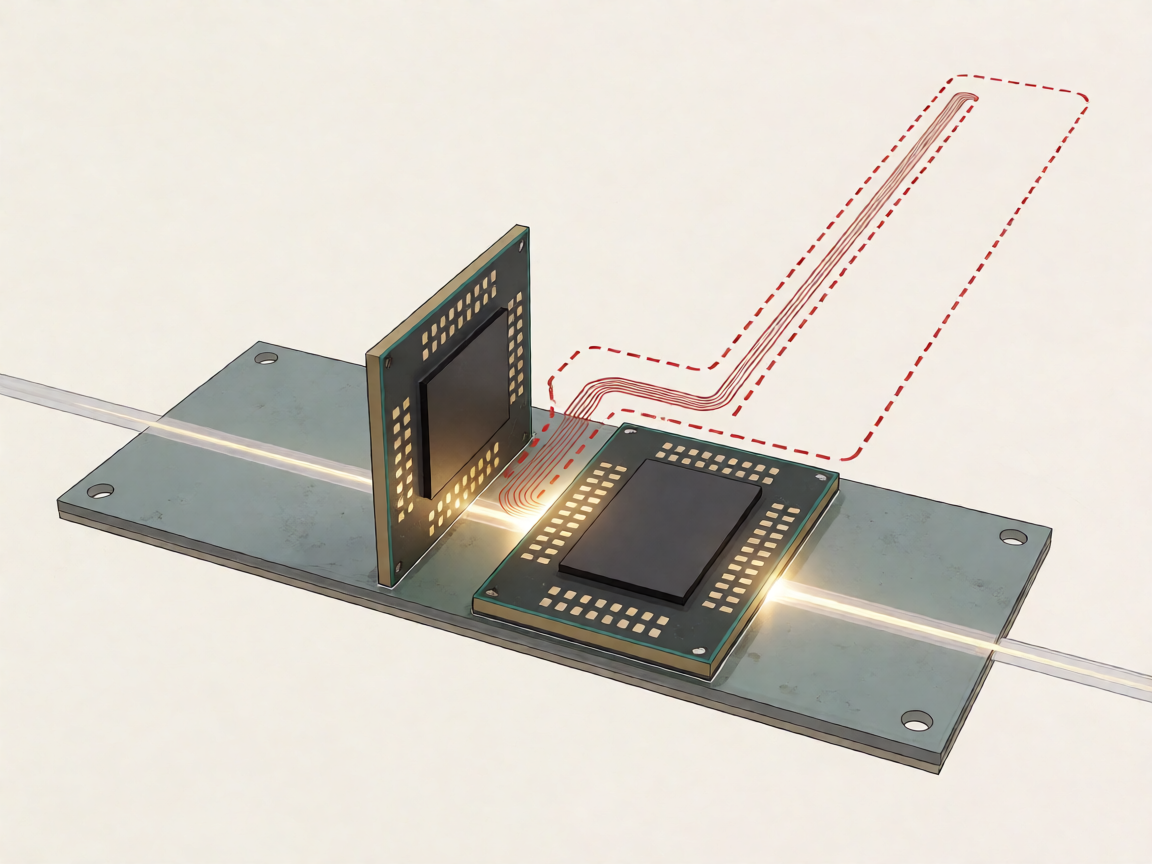
硅光波导与interposer互联的实现路径
CPO的光互联主要有两种物理实现方式。第一种是硅基光互连(silicon photonics),利用硅-on-insulator(SOI)晶圆上的光波导实现芯片间信号传输,成熟度高但耦合损耗较大。第二种是通过2.5D/3D封装中的interposer(中介层),在封装基板内布设高密度光通道,损耗更低但对封装工艺要求极高。两种方式的核心区别在于:硅光波导适合已有硅光产线的厂商,而interposer方案更适合传统封装巨头。
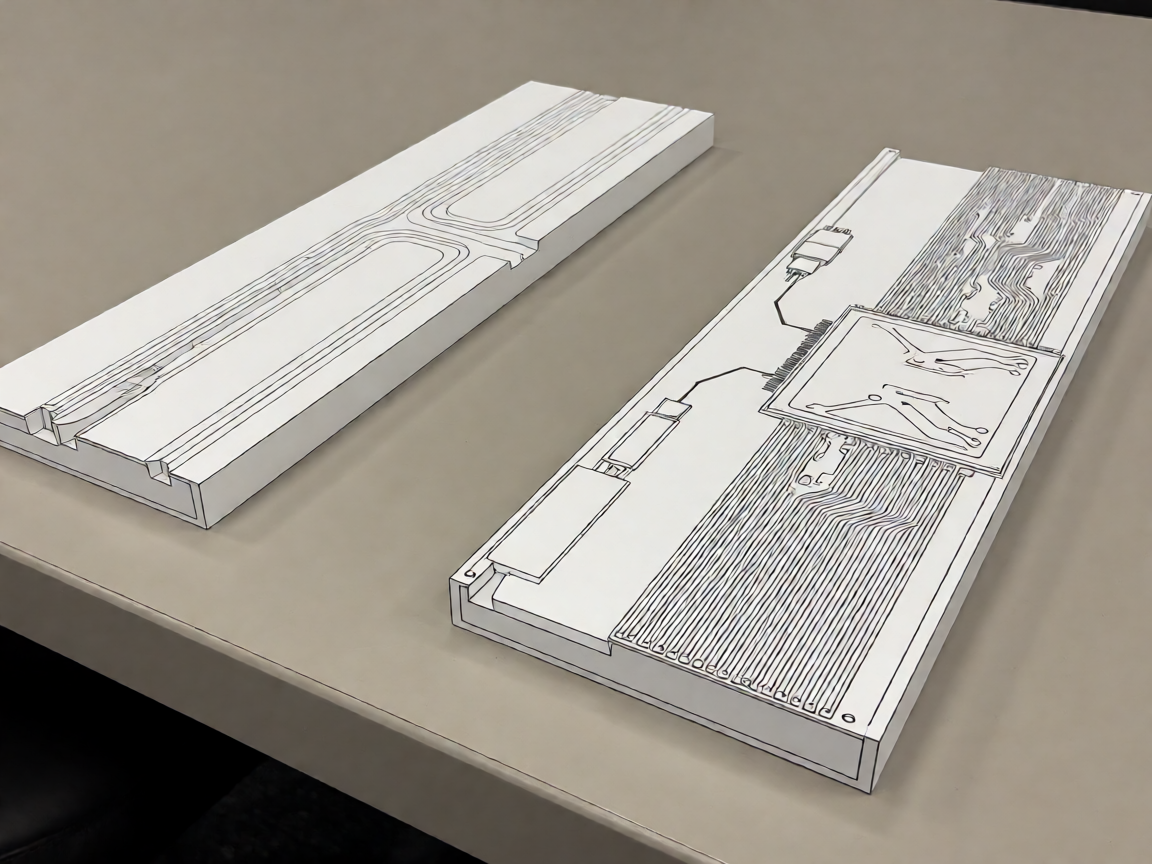
这并非全新概念。Intel在2018年推出的Tahiti芯片就已尝试将光引擎与交换芯片封装在一起。但当时的技术条件不成熟——硅光调制器的能效、激光器的寿命、封装工艺的良率都存在明显问题。如今,这些关键技术在过去五年中取得了实质性进展。
CPO架构面临的核心挑战之一是热管理。交换芯片在运行时的功耗可达1000W以上,而激光器对温度极为敏感——波长漂移超过0.1nm就可能导致信号误码率急剧上升。当发热大户(交换ASIC)和温度敏感器件(激光器)共处同一个封装内时,热设计工程师需要找到新的解决方案。
技术边界:CPO目前不适用于需要频繁更换端口的光模块场景。如果某个端口故障,整个CPO模块需要更换,成本远高于更换一个独立的光模块。这意味着CPO更适合固定部署的场景,如AI训练集群的核心层交换机。
两条技术路线:谁在押注什么
CPO赛道上的参与者主要分为两类。一类是从传统交换芯片厂商转型,如Broadcom和NVIDIA,他们在ASIC设计中直接集成光引擎接口,依赖现有生态系统推进。另一类是纯光子初创公司,如Lumentum、Inphi(已被Marvell收购)和Ayar Labs,他们专注于光引擎本身的微型化和能效优化。
Ayar Labs的方案尤为特殊:他们开发的是’光I/O芯片’——一个拇指大小的硅光芯片,直接插在标准PCIe插槽位置,取代传统铜线缆。这意味着服务器之间的通信不再需要光模块,而是通过光I/O芯片实现点对点光互联。这种方案跳过了交换机,在拓扑结构上与CPO形成互补而非竞争关系。
另一个值得关注的玩家是TeraPhoton,一家专注于硅光集成的初创公司。他们的方案是将激光器外置(避免封装内热管理问题),仅将调制器和探测器集成在封装内,通过光纤阵列与交换芯片连接。这种’半共封装’思路在热管理和维护便利性之间取得平衡,但牺牲了部分功耗优势。
- Broadcom方案:在Tomahawk系列交换芯片中预留光引擎接口,依赖合作伙伴提供光模块
- NVIDIA方案:将光互联深度集成于NVLink架构,封闭生态但性能最优
- Ayar Labs方案:独立光I/O芯片,兼容现有PCIe标准,开放但需重建生态
- TeraPhoton方案:半共封装,激光器外置,热管理更简单
热管理与可靠性的真实挑战
共封装光学最大的技术障碍不是光引擎本身,而是系统集成后的可靠性问题。一个传统可插拔光模块的生命周期为5到10年,期间可以单独更换。而CPO方案中,光引擎与交换芯片共同封装,一旦光引擎失效,整个交换芯片模组都需要更换。
热电冷却器与封装材料的热设计策略
业界应对热管理挑战的核心手段是热电冷却器(TEC)。TEC可以在激光器附近建立局部恒温环境,将温度波动控制在±0.1°C以内,从而保证波长稳定性。但TEC本身会消耗额外功率(约占光引擎总功耗的20%-30%),需要在系统级热预算中单独核算。另一种思路是采用低热膨胀系数的封装基板材料(如硅基嵌入式布线基板或玻璃基板),减少热循环引起的微观应力,但这会显著增加制造成本。
热设计方面,交换ASIC的典型功耗为800W到1500W,而激光器在连续工作状态下也需要1-3W的恒定功耗。两者在同一个封装内的温度梯度可能超过20°C,这会导致硅光波导的热膨胀失配,长期运行可能引发微观裂纹。
业界目前的应对策略包括:使用热电冷却器(TEC)对激光器进行独立温控;采用低热膨胀系数的封装基板材料;以及设计可预测的退化模型,在光引擎性能下降到阈值前提前预警并更换。
风险提示:CPO在早期部署阶段的最大风险不是技术失败,而是维护成本。一个1.6T CPO交换模块的价格预计在$15000-$25000之间,远高于同等功能的可插拔方案。这意味着数据中心的总拥有成本(TCO)评估需要更长的时间尺度才能得出有意义的结论。
对AI基础设施的影响
如果CPO在3到5年内实现规模化部署,最直接的受益者是AI训练集群的网络带宽密度。当前一个800G交换机的端口密度上限约为64个1.6T端口,而CPO方案理论上可以将端口密度提升3到5倍,因为这消除了光模块的物理尺寸约束。
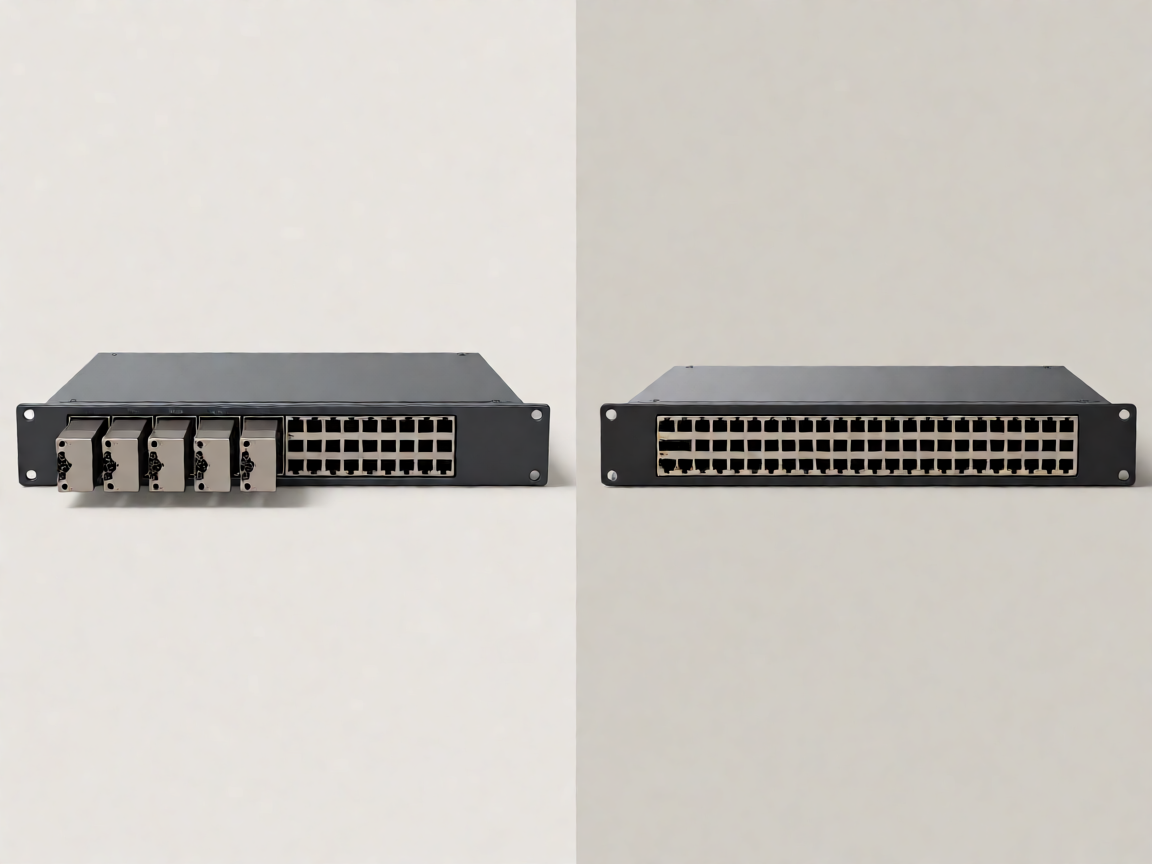
端口密度与训练效率的实际换算
以万卡H100集群为例,使用传统可插拔光模块的1.6T交换机网络大约需要128台交换机,而CPO方案在同等端口密度下可能只需32到42台。这意味着机柜空间节省约60%,同时网络跳数减少带来的端到端延迟下降幅度可达15%-25%。对于需要数周训练的LLM任务而言,这一延迟压缩可能节省数十小时的训练时间。
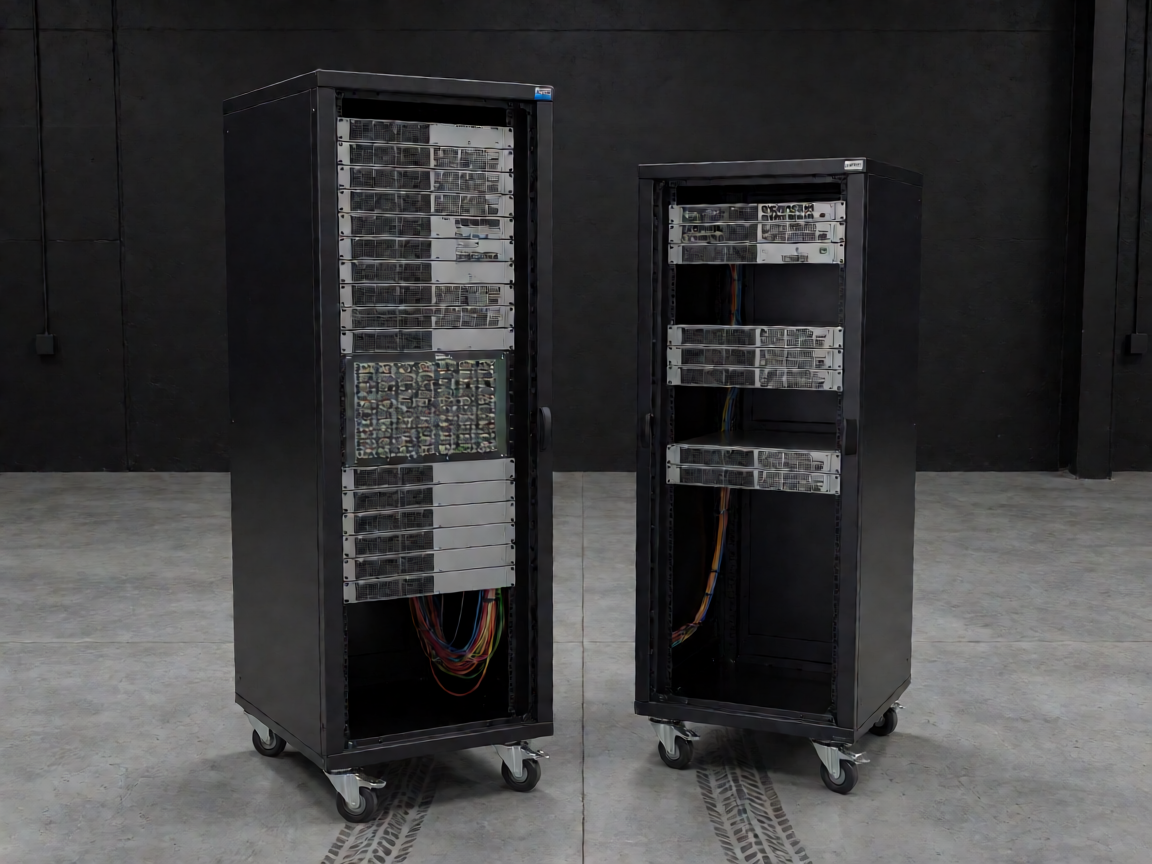
这意味着同样的机柜空间内可以部署更多GPU,或者在相同的GPU数量下使用更小规模的交换机网络,从而降低整体网络的跳数延迟。对于万卡级集群而言,每减少一跳延迟,训练时间可能缩短数小时甚至数天。
但从更宏观的角度看,CPO的真正意义在于它标志着数据中心网络架构范式的转变:从’计算为主、通信为辅’转向’计算与通信深度融合’。当光信号不再作为外部接口存在,而是成为芯片封装内的基础设施时,整个芯片设计、散热设计、甚至数据中心的电力分配策略都需要重新思考。
接下来值得关注什么
OCP(开放计算项目)正在推动CPO标准的制定,预计2026年底将发布第一版共封装光学接口规范。这将决定不同厂商的光引擎是否可以互换,是CPO能否形成规模化生态的关键一步。
另一个关注点是硅光调制器的能效指标。目前商用CPO方案的每比特能耗约为1pJ/bit左右,距离理想值(0.1pJ/bit)仍有数量级差距。这个指标直接决定CPO相比可插拔方案的实际功耗优势是否足以抵消维护成本的上升。
还有两个值得持续观察的动态:一是Intel是否会在下一代数据中心交换芯片中正式支持CPO接口;二是NVIDIA在Blackwell架构之后是否会推出基于CPO的新一代网络方案,以巩固其在AI集群网络中的生态优势。
后续观察:CPO的商业化时间表取决于三个变量——硅光良率成本曲线、OCP标准最终形态、以及超大规模云厂商的实际部署意愿。目前所有变量都处于早期阶段,乐观估计大规模部署将在2028年后出现。
总结
共封装光学代表了数据中心网络架构的一次根本性重构。它将光引擎从可插拔模块下沉到交换芯片封装内部,通过消除长距离铜走线来解决800G以上速率的信号完整性问题。功耗优势显著,但热管理、可靠性和维护成本仍是现实挑战。
对于普通读者而言,理解CPO的意义不在于掌握具体技术参数,而在于认识到:AI的瓶颈正在从’算力’向’算力与通信的协同效率’迁移。当单芯片算力趋近物理极限时,系统架构创新将成为下一个决定性因素。
以实际结果为准,操作前请核对官网版本、授权和安全提示。
欢迎留下你的观点,成为第一个参与讨论的人。