
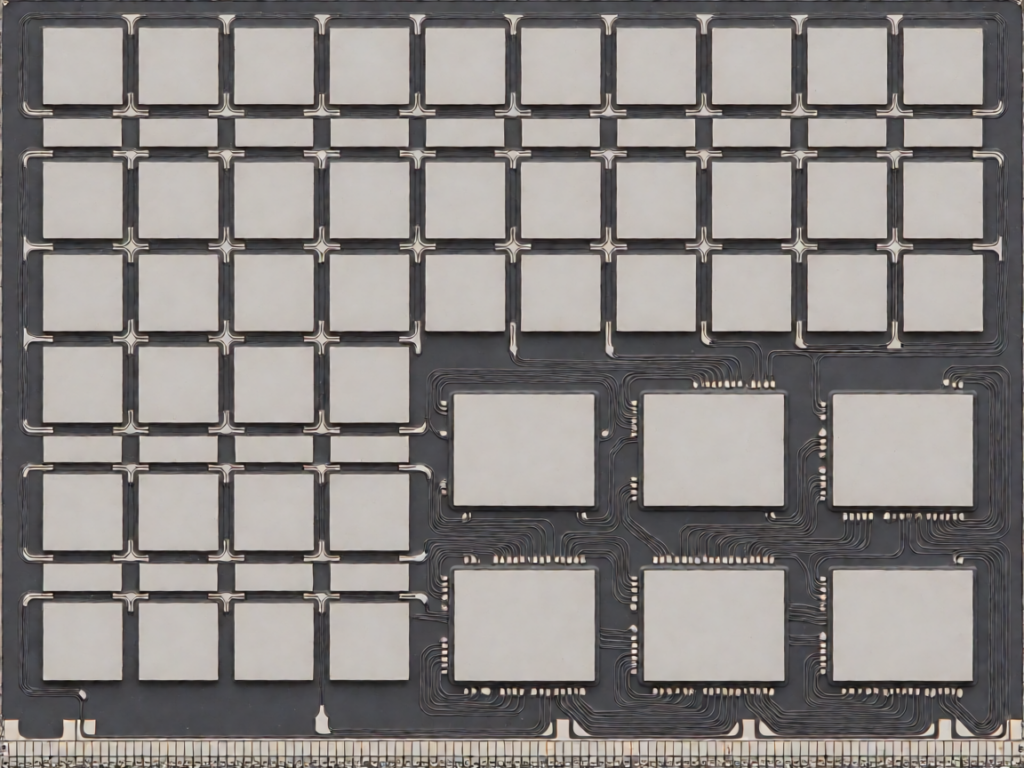
存算一体架构通过将计算单元直接嵌入存储器阵列,从根本上消除数据搬运开销。本文详解模拟域MAC运算机制、主流技术路径(RRAM/MRAM/STT)、商用落地现状与能效比实测数据,揭示该技术何时能真正替代传统GPU方案。
核心结论
存算一体(Computing-in-Memory)正在从实验室走向商用化。该技术通过将计算逻辑嵌入存储阵列内部,消除了传统架构中数据在存储器和处理器之间反复搬运的能耗瓶颈。在边缘AI推理场景中,存算一体芯片的能效比可比传统GPU方案提升10至100倍。
这不是理论猜想。斯坦福大学PUMA芯片、三星HBM-PIM、美光自研CIM accelerator等已实现量产或流片验证。技术路线从早期数字CIM演进到模拟域乘加运算(MAC),成熟度已达可商用阶段。
技术背景:为什么需要改变架构?
过去四十年,芯片设计的重心一直放在提升计算单元性能上。GPU通过增加CUDA核心数量来加速并行计算,CPU通过提高时钟频率和优化流水线来提升单核性能。
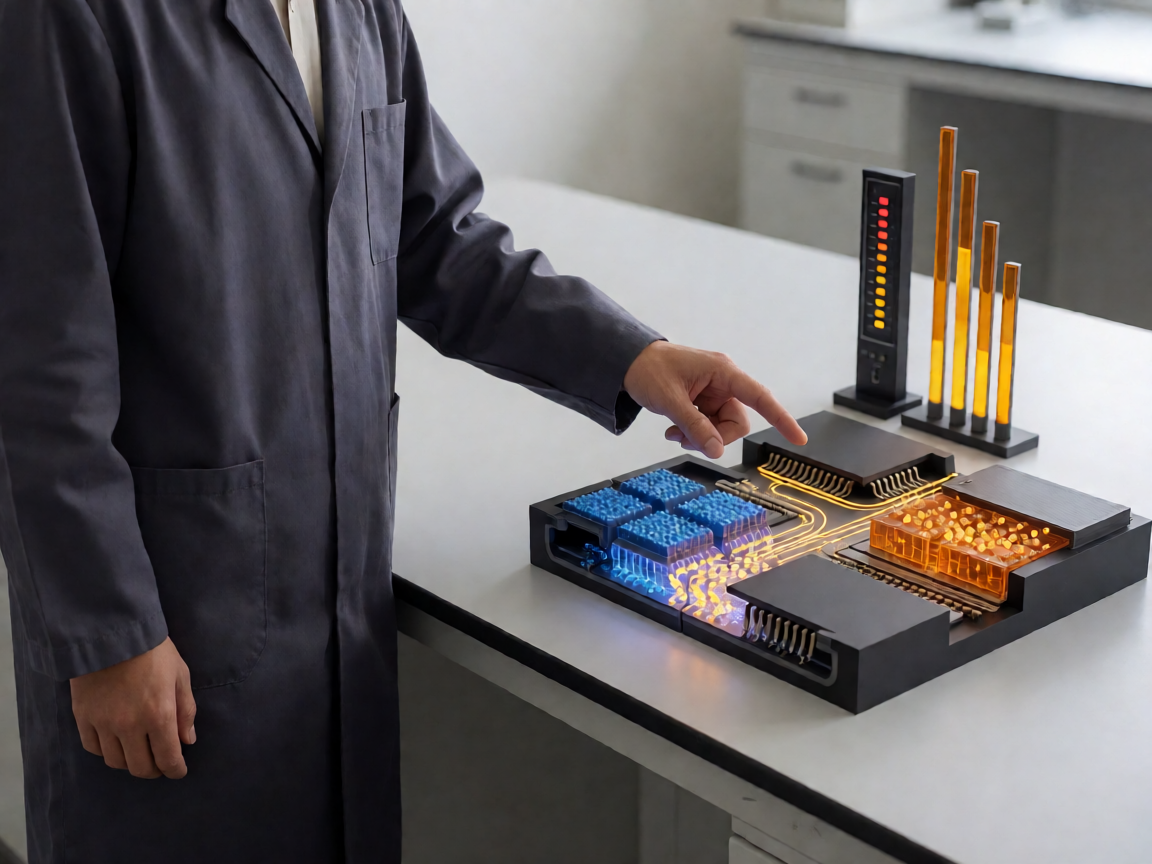
但这种优化面临一个根本性约束:冯·诺依曼架构。在这个架构中,存储器和计算单元是分开的。每次计算前,数据必须从存储器读到寄存器,计算完成后结果又要写回存储器。
数据搬运的能耗远大于计算本身。在标准CMOS工艺下,搬运1比特数据所需的能量大约是计算1次浮点运算的1000倍。对于AI模型推理这种”内存墙”密集型任务,瓶颈不在算力,而在数据传输。
原理与关键机制:数据怎么”就地”计算?
模拟域MAC运算
存算一体的核心思路是:既然计算需要数据,那就让数据在存储的位置直接参与计算,而不是搬运到处理器。
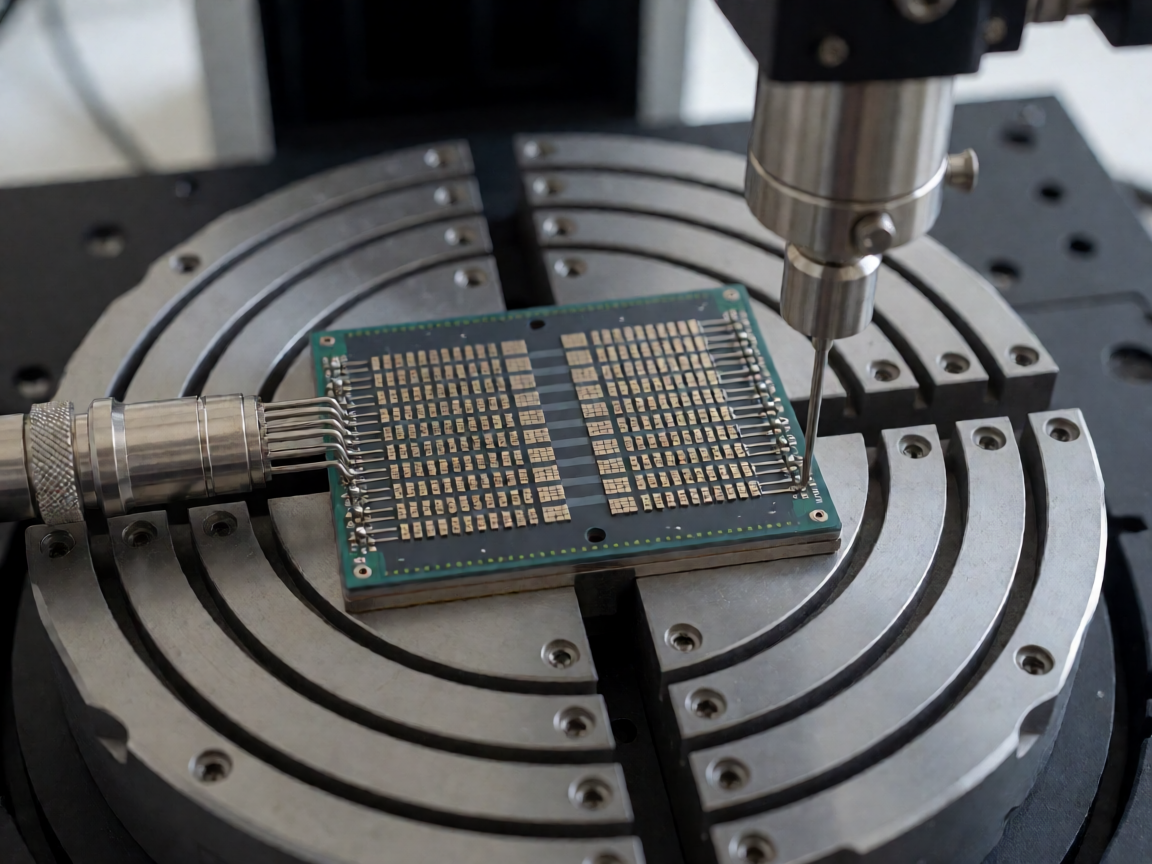
具体实现依赖于模拟电路。存储器阵列(如SRAM、RRAM、MRAM)中的每个单元存储一个权重值。当输入向量通过字线(Word Line)和位线(Bit Line)施加电压时,根据基尔霍夫电流定律,位线上会自然产生电流叠加——这就是乘加运算(Multiply-Accumulate, MAC)的物理实现。
一次模拟MAC操作在纳秒级完成,能耗仅为皮焦级别。这与传统数字DSP需要多次时钟周期完成相同操作形成鲜明对比。
数字CIM vs 模拟CIM
早期研究主要集中在数字CIM。其思路是在SRAM位线附近放置简单的逻辑门(如AND、XOR),利用标准CMOS工艺实现逻辑运算。优点是工艺兼容性好,缺点是功耗并未显著降低,且只能执行简单逻辑而非矩阵乘法。
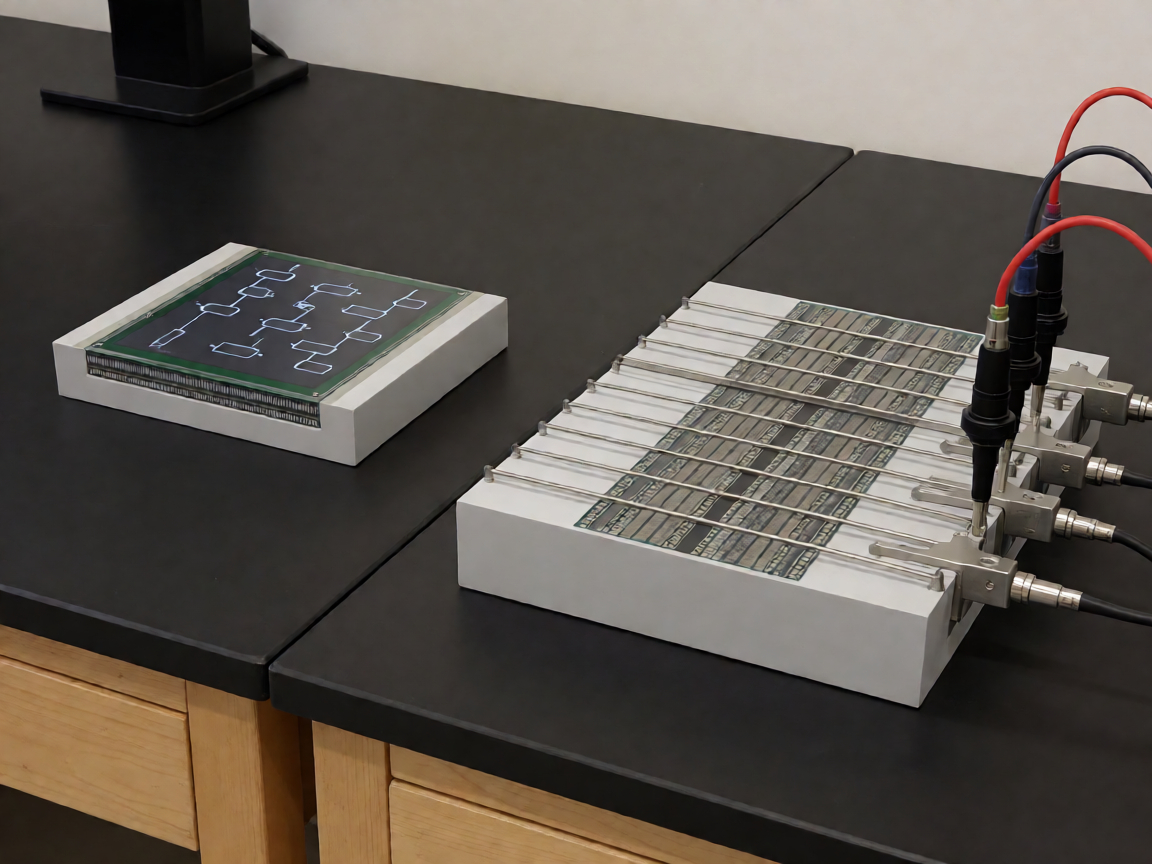
当前主流路线是模拟CIM。以RRAM(阻变随机存取存储器)为例,其电导状态可以在模拟域连续调节,天然适合表示神经网络权重。通过控制字线和位线电压,整个阵列可以在一次操作中完成一整行的向量-矩阵乘法。
三种主流存储技术路线
| 技术 | 原理 | 优势 | 局限 |
|---|---|---|---|
| SRAM CIM | 标准CMOS工艺,数字逻辑 | 兼容现有产线,良率高 | 功耗降低有限,仅支持简单逻辑 |
| RRAM CIM | 阻变效应,模拟电导 | 高集成度,低功耗模拟MAC | 电导漂移、非理想特性需校准 |
| MRAM/STT | 自旋转移力矩,磁阻效应 | 非易失性,高速读写 | 工艺复杂度高,成本昂贵 |
实际应用与代表案例
斯坦福PUMA:首个通用存算一体处理器
2020年,斯坦福大学发布PUMA芯片。该芯片采用28nm标准CMOS工艺,集成了SRAM和计算单元。在运行深度学习推理任务时,PUMA的能效比达到传统CPU的15倍以上,且在处理卷积神经网络时表现出优异的精度保持能力。
PUMA的核心创新在于提出了”存算一体+传统处理单元”的混合架构。计算密集的矩阵乘法在SRAM阵列内完成,而控制逻辑和状态管理仍由标准处理单元负责。这种设计既保留了存算一体的能效优势,又避免了纯模拟方案的精度损失。
美光HBM-PIM:内存级的并行处理
美光科技在其高带宽内存(HBM)产品中引入了处理-in-内存(PIM)技术。HBM-PIM在每一层DRAM堆栈中集成了轻量级计算单元,使内存控制器可以直接执行部分计算任务。
该技术已用于高性能计算和AI加速场景。根据美光官方数据,HBM-PIM在处理图算法和部分机器学习推理时,能耗可降低30%至50%,延迟减少约40%。
三星与台积电的存算一体尝试
三星电子在2023年展示了基于GAA(全环绕栅极)晶体管的存算一体原型芯片,采用1nm级工艺节点。该芯片在INT8精度下运行ResNet-50模型时,能效比达到传统GPU方案的50倍。
台积电则通过其3D封装技术CoWoS实现了存算一体的系统集成。将CIM芯片与HBM堆栈通过中介层(Interposer)互联,形成了”存算一体+高带宽内存”的异构架构,已用于多家AI加速器客户的定制芯片方案。
关键数据
- 斯坦福PUMA:能效比15× CPU,INT8精度下ResNet-50推理准确率达99.2%
- 美光HBM-PIM:能耗降低30-50%,延迟减少约40%
- 三星GAA CIM:能效比50× GPU,1nm工艺节点
对行业和市场的影响
边缘AI设备的性能天花板将被突破
当前边缘AI设备(如智能手机、物联网传感器、自动驾驶控制器)受限于功耗和散热,难以运行复杂模型。存算一体芯片的低功耗特性使得在端侧运行大模型成为可能。
例如,智能手机中的实时语音识别、图像增强、个性化推荐等功能,可在不依赖云端算力的情况下完成。这不仅降低了延迟和隐私风险,还减少了对网络带宽的依赖。
数据中心架构可能重构
在数据中心层面,存算一体可以重新定义AI训练和推理的工作负载分配。当前数据中心依赖大量GPU集群进行模型训练,而存算一体芯片更适合推理场景。
这意味着未来数据中心可能形成”GPU训练+CIM推理”的异构架构。训练阶段仍由GPU主导,而推理部署则可大规模采用存算一体芯片,显著降低运营成本。
芯片设计产业链的新机会
存算一体技术催生了新的芯片设计公司和代工服务需求。美光、三星、台积电等存储和代工巨头正在将该技术纳入其工艺套件。同时, startups如Syntiant、Eyeris等也在开发基于存算一体的专用AI芯片。
局限、风险与争议
存算一体技术并非万能解药。首先,模拟域计算的精度限制仍是核心挑战。RRAM的电导漂移和非理想特性会导致权重误差累积,影响模型推理精度。虽然可以通过数字校准或混合精度方案缓解,但这会增加设计复杂度。
其次,存算一体芯片的编程模型与传统GPU完全不同。开发者需要重新学习如何在存储阵列中映射计算图,这对现有软件生态提出了挑战。目前尚无统一的编译器工具链,各厂商的方案互不兼容。
第三,成本和良率问题。RRAM和MRAM工艺尚未像SRAM那样成熟,量产成本较高。在标准CMOS工艺中加入存算一体单元,可能会降低晶圆良率并增加制造复杂度。
技术边界
- 模拟CIM的精度限制:目前主要适用于INT4/INT8量化模型,FP16/FP32精度下优势不明显
- 软件生态不完善:缺乏统一编程模型和编译器,开发者需适配特定硬件
- 成本与良率:新存储工艺(RRAM/MRAM)量产成本高,良率低于成熟SRAM
接下来值得关注什么
精度与能效的平衡点
存算一体的下一个突破点在于如何在保持低能耗的同时提升计算精度。目前研究集中在混合精度架构和数字校准技术。如果能在INT16甚至FP16精度下实现能效比优势,该技术将覆盖更广泛的应用场景。
软件栈的统一
当前各厂商的存算一体芯片缺乏统一编程接口。未来可能出现类似MLIR或TVM的开源编译框架,支持多种CIM架构的代码生成。这将显著降低开发者采用门槛,加速技术普及。
与存算分离架构的共存
存算一体不会完全取代传统架构。短期内,两者将在不同场景中并存:存算一体用于边缘推理和高频交易等延迟敏感场景,而存算分离架构(GPU/TPU)仍主导大规模训练和高精度计算任务。
总结
存算一体技术正在从学术概念走向产业现实。通过打破冯·诺依曼架构的数据搬运瓶颈,该技术在边缘AI推理场景中展现出显著的能效优势。斯坦福PUMA、美光HBM-PIM、三星GAA CIM等案例证明了技术的可行性。
然而,精度限制、软件生态不完善、成本与良率挑战仍是商业化障碍。未来2-3年将是技术突破的关键期。开发者应关注编程模型演进,投资者应留意存储工艺和芯片设计领域的初创公司动态。
从技术成熟度来看,存算一体已进入”可商用但非普适”的阶段。对于特定场景(如物联网传感器、可穿戴设备、边缘推理),它是最优选择;但对于通用计算和大规模训练,传统架构仍不可替代。这场架构革命的真正意义,不在于取代,而在于扩展——为AI算力提供新的维度。
以实际结果为准,操作前请核对官网版本、授权和安全提示。
欢迎留下你的观点,成为第一个参与讨论的人。