解析端侧AI推理技术的最新进展,探讨NPU如何突破算力瓶颈,实现手机本地运行大模型,以及这一技术对隐私保护、成本控制的实际价值与当前限制。
核心结论:端侧AI正在从概念走向实用,但仍有明确边界
2024年以来,随着NPU算力的快速提升和模型压缩技术的成熟,在手机、PC等终端设备上本地运行AI模型已从技术演示变为实际可用。这一趋势的核心驱动力并非追求完美体验,而是解决隐私敏感场景下的推理需求,以及降低云端调用的持续性成本。
端侧AI的真实价值不在于取代云端大模型,而在于填补两者之间的空白地带——那些对延迟、隐私、稳定性有刚性要求的场景。
关键判断:端侧AI目前更适合中等规模模型(7B参数以下)的推理优化,而非全量大模型的本地化部署。技术成熟度处于”可用但不完美”阶段。
技术背景:为什么需要把AI推搬到终端
传统的大模型推理依赖云端服务器,这种架构存在三个持续痛点:隐私数据需要上传至第三方服务器,网络不稳定导致服务中断,以及大规模并发带来的运营成本压力。
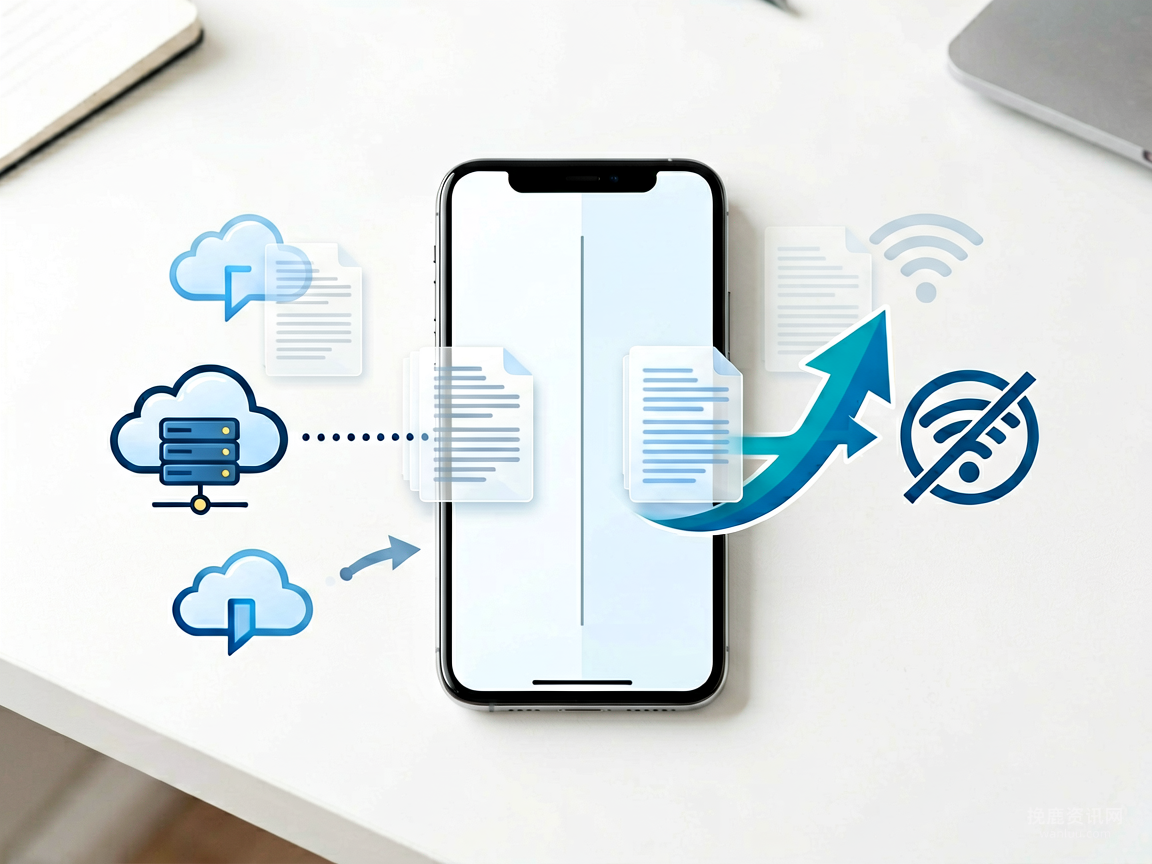
端侧AI的思路是在设备本地完成推理计算,无需联网即可完成基础任务。这一方案的提出并非为了追求技术炫技,而是基于明确的场景需求。
- 隐私敏感场景:医疗记录、财务数据、个人通信等内容不适合上传云端
- 离线可用需求:飞行模式、偏远地区、网络受限环境仍需AI能力
- 成本敏感场景:高频用户每天产生大量请求,云端调用成本显著
硬件层面的突破同样关键。过去十年,移动SoC的NPU算力从每秒数千亿次运算提升至数万亿次,为复杂模型推理提供了物理基础。
原理机制:NPU如何高效执行AI推理
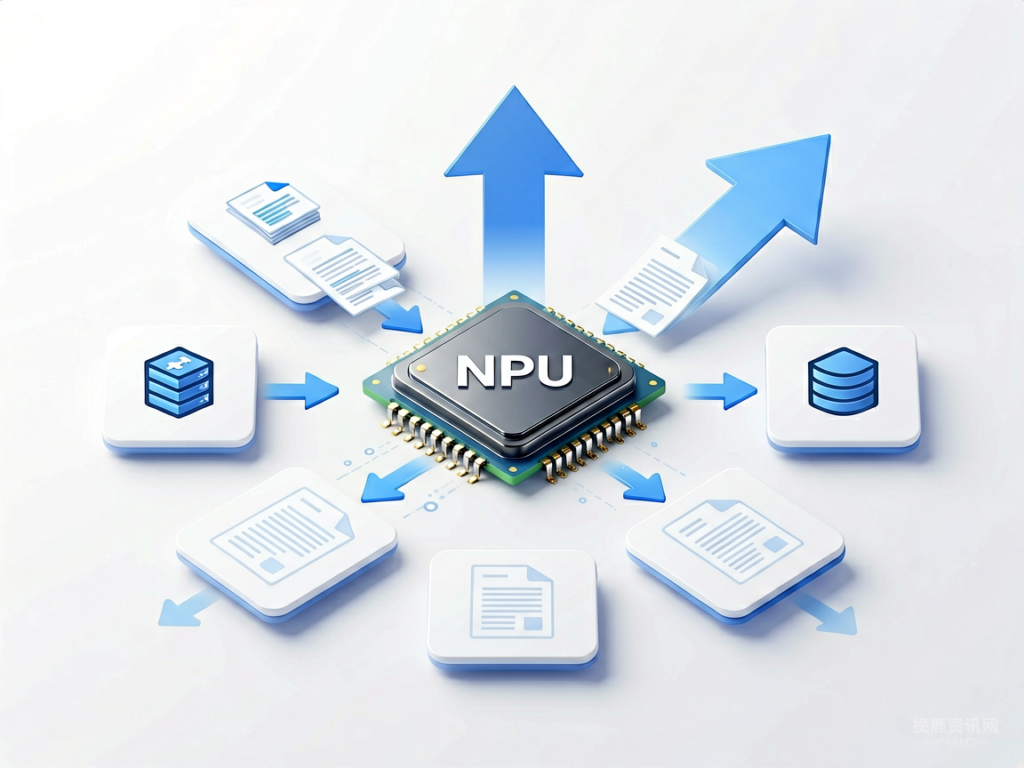
NPU(神经网络处理器)是专为矩阵运算设计的专用芯片架构。与CPU的通用计算、GPU的并行浮点运算不同,NPU针对深度学习中的张量操作进行了硬件级优化。
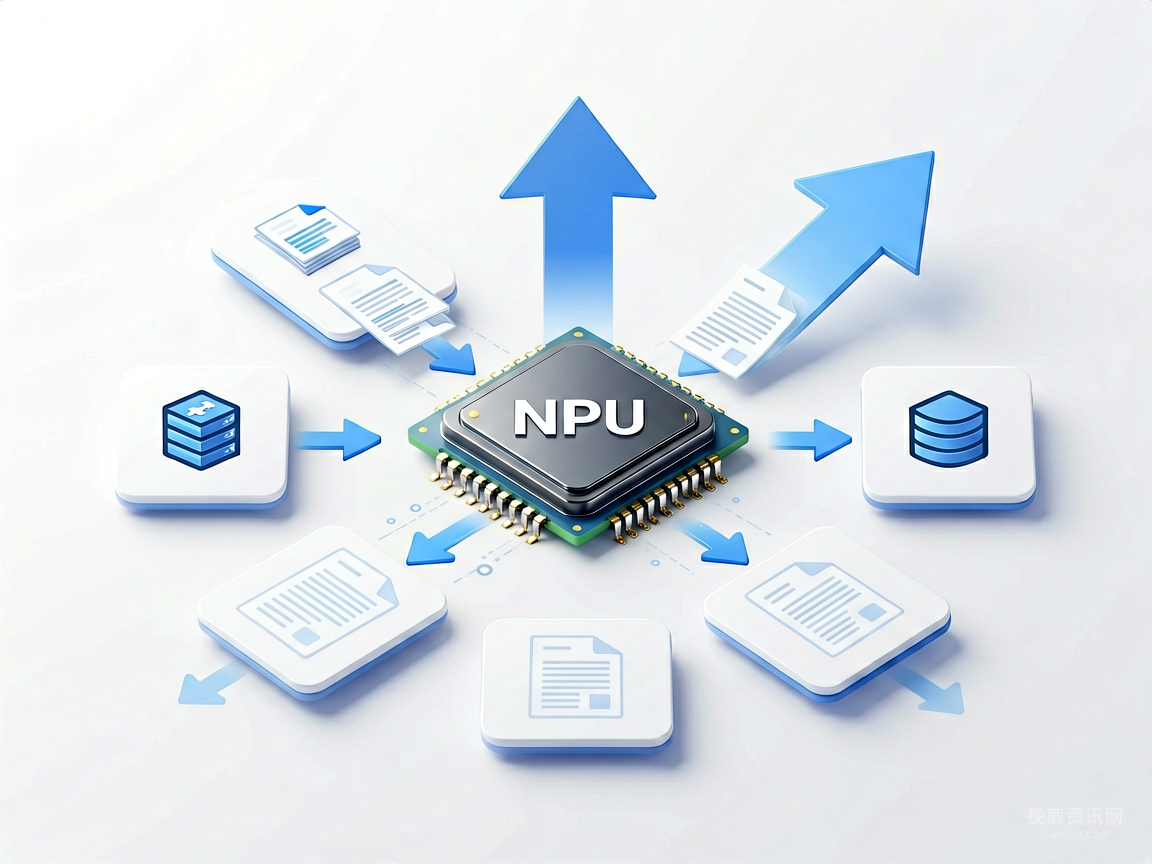
其核心设计逻辑是”数据流驱动计算”——通过预置的存储结构和调度机制,减少数据在寄存器、缓存、内存之间的搬运次数,从而降低功耗并提升吞吐量。
典型NPU计算流程:输入张量 → 权重加载 → 矩阵乘加运算 → 激活函数 → 输出张量
与传统GPU对比:GPU采用SIMD架构处理大规模并行任务,NPU采用数据流架构优化内存访问模式
模型压缩技术是端侧AI落地的另一支柱。常见的压缩方法包括量化(将32位浮点数转为8位整数)、剪枝(移除冗余神经元连接)、知识蒸馏(用小模型学习大模型行为)等。
技术边界:过度压缩会导致模型精度下降,尤其是推理复杂逻辑和多步链式任务时,端侧模型表现明显弱于云端同规模模型。
| 指标 | 云端GPU推理 | 端侧NPU推理 |
|---|---|---|
| 典型延迟 | 500ms – 2s | 100ms – 500ms |
| 能耗 | 数据中心供电 | 电池供电,需严格控制 |
| 隐私性 | 数据需上传 | 本地处理,不流出设备 |
| 离线能力 | 不可用 | 完全可用 |
| 并发规模 | 数千到数万请求 | 单用户单任务为主 |
实际应用:当前可用的端侧AI场景
2024年至2025年间,主流手机厂商已在设备中部署本地AI能力。这些实现并非完整大模型,而是针对特定任务优化的轻量化模型。
图像生成与编辑
手机端本地运行的图像生成模型参数量通常在1B到3B之间,通过扩散模型架构实现。虽然生成速度和细节丰富度不及云端服务,但对于日常修图、创意草图已能满足基础需求。
典型应用场景包括:照片背景替换、老图修复、简单艺术风格转换。这些任务的共同特点是输入输出明确、计算复杂度可控。
语音助手与文本处理
端侧ASR(自动语音识别)和本地语言模型已实现常用指令的离线响应。用户说话内容无需上传云端,直接在本设备完成语音转文字和意图识别。
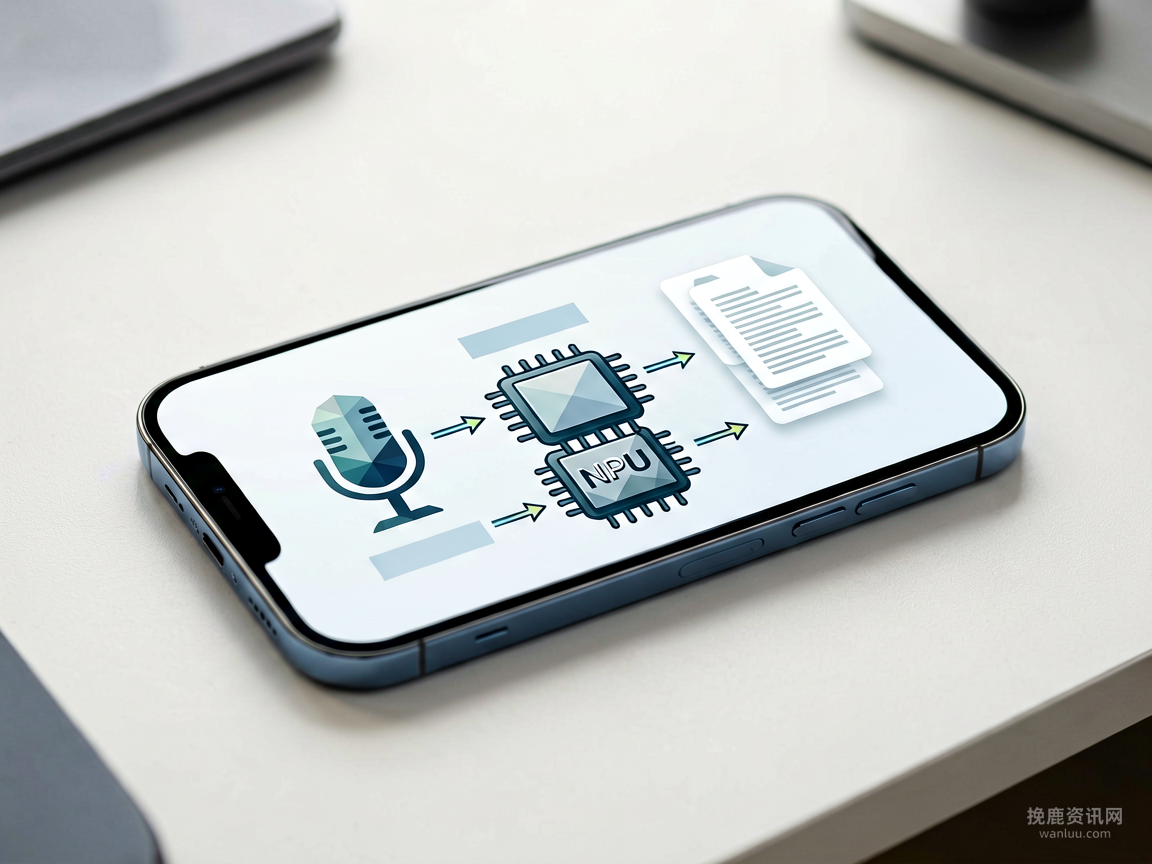
对于写作辅助、摘要生成等文本任务,7B量级的本地模型可提供基础支持,但在复杂推理和长文本理解方面仍显不足。
实时翻译与字幕
端侧翻译模型利用NPU的并行计算能力实现低延迟翻译,适用于会议记录、旅行场景等对实时性要求较高的场合。本地处理避免了网络延迟,同时保护对话内容的隐私性。
产业影响:重新定义AI服务的分发逻辑
端侧AI的普及正在改变AI服务的商业形态。过去,AI能力主要通过API调用的方式提供,用户按请求量付费。现在,部分能力已内置于设备中,成为硬件的标配功能。
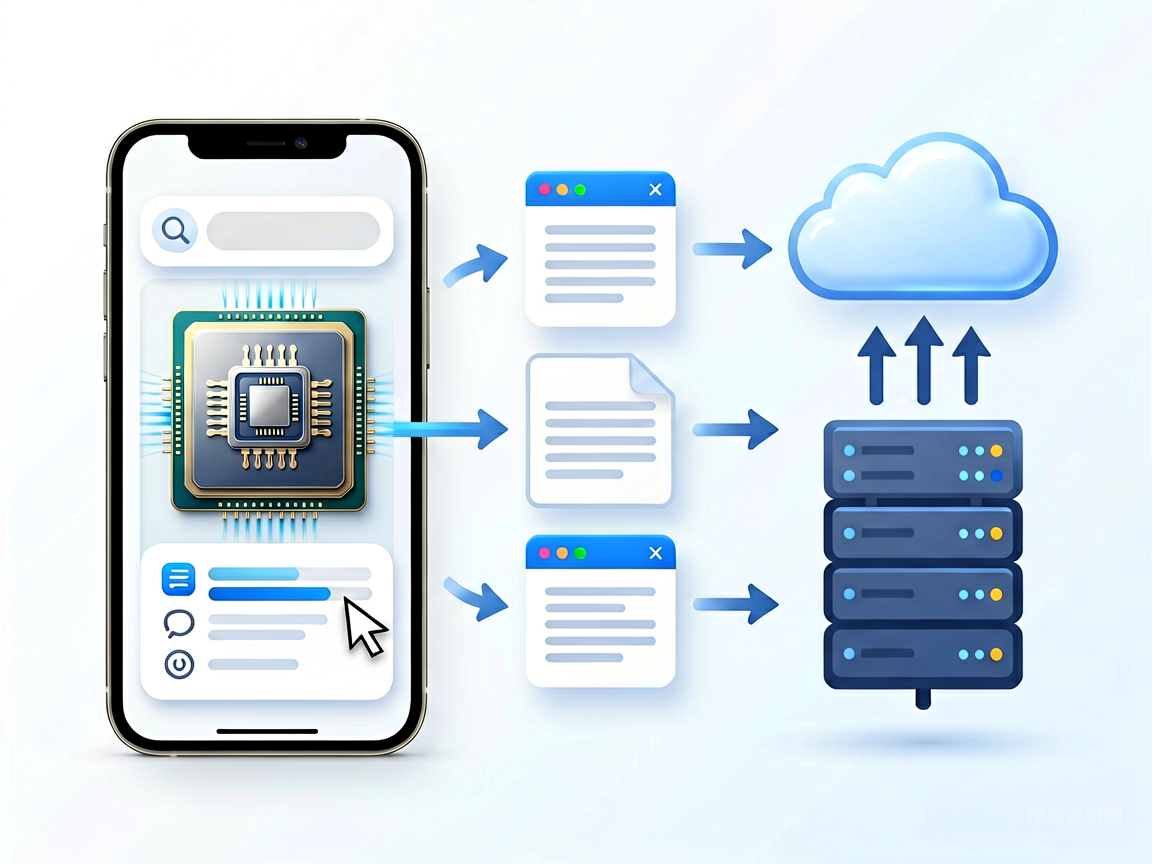
这一转变对产业链产生多层次影响:芯片厂商需要持续优化NPU算力与功耗比,应用开发者需要适配本地模型的接口约束,云服务提供商则面临基础推理业务的迁移压力。
市场判断:端侧AI不会完全替代云端推理,而是形成分层架构。简单、高频、隐私敏感的任务留在终端,复杂、低频、需要超大模型能力的任务仍依赖云端。
对普通用户而言,最直接的感受是部分AI功能的响应速度变快、使用门槛降低,但同时也意味着需要购买支持相应硬件的新设备才能体验完整能力。
当前限制与风险:技术尚未成熟的部分
尽管进展显著,端侧AI仍面临多重约束,这些限制在短期内难以根本解决。
算力与存储的物理瓶颈
手机端NPU算力虽在提升,但与数据中心GPU集群仍存在数量级差距。同时,运行大模型需要大量内存,当前手机内存配置难以支持超大规模模型的完整加载。
模型压缩虽然能减小体积,但精度损失不可避免。对于需要高准确率的场景,端侧方案仍显不足。
发热与续航压力
长时间高负载推理会导致设备明显发热,进而触发温控降频,反而降低推理速度。电池消耗也是现实问题,重度AI任务会显著缩短设备续航时间。
使用建议:端侧AI适合短时、间歇性使用,不建议作为长时间连续推理的解决方案。需要复杂计算的任务仍应借助云端或专用设备。
模型更新与维护
云端大模型可以持续迭代优化,用户无需任何操作即可享受最新能力。端侧模型则依赖厂商推送更新,存在滞后性,且存储空间有限,难以频繁更换大模型。
后续关注:技术演进的关键节点
端侧AI的未来发展取决于几个技术突破方向。首先是模型架构的创新,如Mixture of Experts(混合专家)模式可能通过动态调用子模型来平衡性能与效率。
其次是硬件层面的进步,存算一体、光子计算等新技术若能在消费级产品上落地,将显著改善能效比。
- 模型压缩算法的持续优化,在保持精度的同时进一步减小体积
- NPU架构的代际升级,算力与能效比保持年增长态势
- 操作系统层面的统一调度,实现云端与端侧能力的无缝切换
- 开源模型的端侧适配,降低开发者接入门槛
对于普通用户,未来1到2年内最值得关注的变化是:更多旗舰设备将标配更强的NPU,本地AI功能的可用性和自然度将显著提升,但完全依赖本地运行超大模型的场景仍不现实。
总结
端侧AI是AI普及化进程中的重要一环,它解决了隐私保护和离线可用等实际问题,也让AI能力更自然地融入日常设备。然而,受限于物理条件和算法现状,端侧AI目前更适合中等复杂度任务,而非全面替代云端大模型。
技术发展的趋势是云端与端侧的协同:云端负责复杂推理和模型训练,端侧负责实时响应和隐私敏感任务。这种分层架构既能保证能力上限,又能满足多样化场景需求。
对于用户而言,不必期待端侧AI一次性解决所有问题,也不应忽视其在特定场景下的独特价值。理解技术的边界,才能更理性地选择和使用AI工具。
以实际结果为准,操作前请核对官网版本、授权和安全提示。
欢迎留下你的观点,成为第一个参与讨论的人。