存内计算通过将计算集成到存储单元内部,消除数据搬移瓶颈,在边缘AI推理场景中实现数量级能效提升。本文解析其原理、典型应用案例、产业影响及当前局限。
核心结论
存内计算(Computing-in-Memory,CIM)通过将计算逻辑直接集成到存储单元内部,从根源上消除数据在存储与处理器之间的搬移开销,在AI推理任务中可实现10至100倍的系统能效提升。2025至2026年,多家芯片厂商与科研机构已推出可商用的存内计算原型芯片,主要面向边缘智能、可穿戴设备以及低功耗数据中心场景,但精度、编程灵活性及制造工艺仍是规模化落地的关键瓶颈。
技术背景:为什么“内存墙”必须被打破
传统冯·诺依曼架构中,CPU/GPU与内存物理分离,每次AI推理都需要从DRAM读取权重和中间结果,再写回。随着模型参数突破千亿,数据搬移的能耗已占系统总功耗的60%至80%,形成“内存墙”瓶颈。例如,一次矩阵乘法操作中,数据搬运能耗是实际计算能耗的数十倍。在边缘设备(如智能音箱、工业传感器)上,电池容量限制了推理频率,传统架构难以满足低功耗实时需求。
这一矛盾在2024–2026年变得更加尖锐:大模型从云端向端侧迁移的趋势明确,但端侧芯片的存储带宽和能效提升速度远落后于模型规模增长。行业迫切需要一种从根本上减少数据移动的硬件方案,存内计算因此成为重点研究方向。
原理与关键机制:将计算“嵌入”存储
存内计算的核心思想是让存储单元本身具备计算能力。常见实现方式包括:
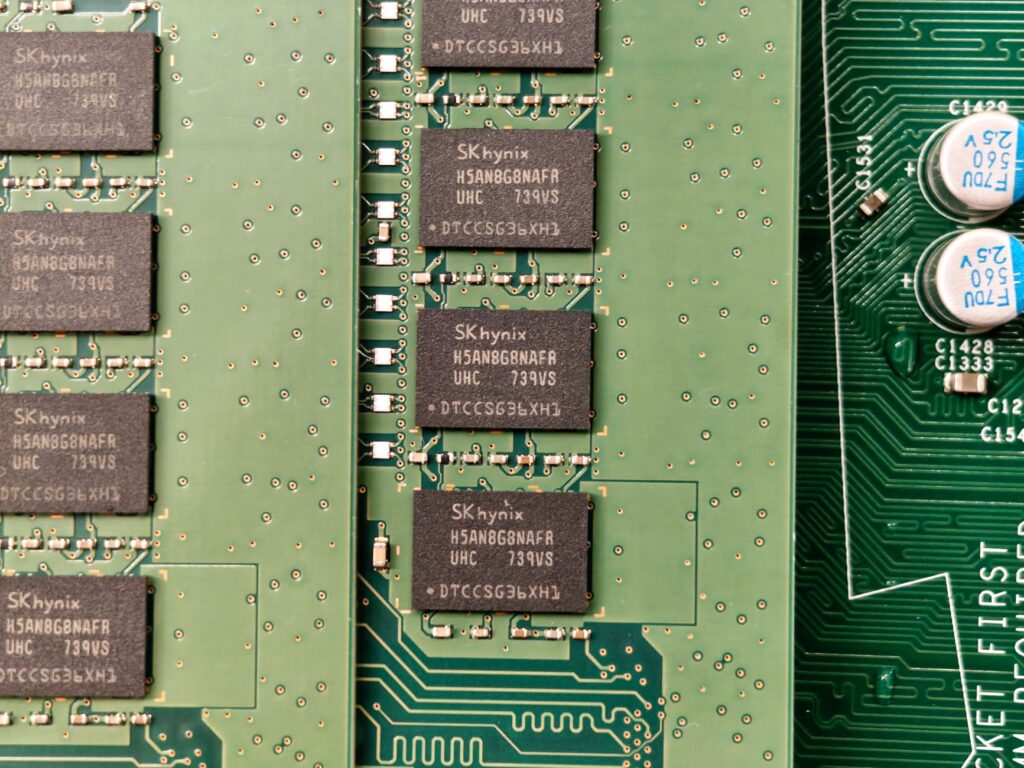
- 基于电阻式随机存取存储器(RRAM)的模拟计算:将权重映射为RRAM单元的电阻值,通过基尔霍夫定律在阵列中直接完成向量-矩阵乘法,输出为模拟电流。一次读取即可完成多次乘加,无需搬移数据。
- 基于SRAM的数字存内计算:在标准SRAM位线上添加逻辑门,支持逐位乘加操作,精度更高但单元面积较大。
- 近存计算(Near-Memory Computing):将计算单元逻辑靠近存储阵列(如封装内集成),虽非真正的“存内”,但可大幅缩短数据路径,是当前商用过渡方案。
以RRAM为例,其典型结构为交叉阵列(Crossbar Array):水平字线、垂直位线,交叉点存放存储单元。当电压施加于字线,电流沿位线流出,自然完成加权求和。该过程完全模拟,无需ADC/DAC多次转换,功耗仅为传统CMOS方案的1/100。
实际应用与代表案例
截至2026年8月,存内计算已在多个场景进入原型验证或小批量生产:
- 三星HBM-PIM:在HBM2E内存中嵌入可编程处理单元,近存计算架构,用于AI推理加速,能效比提升约2.5倍,已在部分数据中心试点。
- 台积电与imec合作的RRAM存内计算芯片:基于28nm工艺,在图像分类任务上达到85%的Top-1准确率,系统能效达到16 TOPS/W,远超传统GPU(约0.5–1 TOPS/W)。
- 国内初创公司如“知存科技”的WTM系列:面向智能语音和传感器融合,在0.1mW功耗下完成实时唤醒词检测,电池续航提升至传统方案的5倍以上。
这些案例验证了存内计算在低功耗、低延迟场景中的显著优势,尤其适合始终在线(always-on)的传感器处理。
对普通用户、行业与市场的影响
- 普通用户:未来搭载存内计算芯片的智能手表、TWS耳机可以实现更复杂的本地语音助手、实时健康监测,而不依赖云端,隐私更强、续航更长。
- 行业:边缘计算、工业物联网、机器视觉质检等场景将获得低成本、高能效的推理芯片,推动AI落地从“云计算依赖”转向“边缘自主”。
- 市场:据Yole Développement预测,全球存内计算市场规模将从2025年的约2亿美元增长至2030年的50亿美元,年均复合增长率高达70%。主要驱动力来自AI终端芯片更新换代。
局限、风险与争议
注意:存内计算目前仍面临多项技术挑战,以下为经公开信息确认的瓶颈。
配图:DS stories · PEXELS LICENSE
- 精度与动态范围:RRAM单元的电阻值存在固有波动,导致模拟计算精度受限(通常8位以下),难以支持高精度训练或复杂推理。
- 编程复杂度:现有深度学习框架(如PyTorch、TensorFlow)无法直接编译到存内计算芯片,需开发专用编译器或显著修改模型结构,增加了迁移成本。
- 工艺成熟度:RRAM芯片的良率与耐久性仍在提升中,目前主流代工厂的RRAM工艺尚未进入量产巅峰,成本和一致性有待改善。
- 与数字生态的兼容性:存内计算适合矩阵乘法主导的推理,但面对稀疏操作、分支预测等不规则任务效率低下,需配合传统数字处理器共存。
接下来值得关注什么
短期(2026–2027年):混合架构芯片(存内计算+传统数字核)将率先进入消费电子领域,如智能手表SoC。长期(2028–2030年):存内计算训练有望突破,即利用反向传播直接在存储阵列上完成梯度更新,彻底消除训练中的内存墙。此外,新型存储材料(如铁电晶体管、自旋转移矩器件)也将进一步降低单元面积与功耗。
总结
存内计算以“数据即计算”的思路,从根本上解构了冯·诺依曼瓶颈,已在边缘AI推理中展现出不可替代的能效优势。尽管精度、生态和工艺仍待成熟,但其在工信部、台积电、三星等产业巨头的推动下,正从实验室快速走向商用。对于普通用户,这意味着更智能、更省电的终端设备;对于开发者,意味着需要开始了解存内计算的编程模型和部署工具。下一代AI芯片的竞争,或许就在“存内”二字之间。
以实际结果为准,操作前请核对官网版本、授权和安全提示。
欢迎留下你的观点,成为第一个参与讨论的人。