
存算一体不是单一技术,而是三条并行的工程路线。ReRAM写入速度快但耐久有限,MRAM读写均衡但工艺复杂,PCM能耗稳定但工艺不成熟。理解它们各自的适用边界,才能判断哪个路线会在哪类任务中率先落地。
冯·诺曼瓶颈正在重新定义芯片设计的优先级
2020年前后,AI训练对算力的需求呈指数增长,但芯片功耗的增长曲线更为陡峭。问题的核心不在于晶体管能做多少计算,而在于数据搬运消耗了多少能量。数据在处理器和内存之间来回移动的时间,已经超过实际计算的时间。
这一现象被称为冯·诺曼瓶颈。传统的存储-计算分离架构下,每一轮矩阵运算都需要将权重参数从内存拉入处理器,再将结果写回。对于深度神经网络动辄数百GB的权重数据,这条搬运路径成为能效的最大瓶颈。
存算一体的核心命题不是”能不能做”,而是”在什么场景下比传统架构更划算”。
学术界和产业界因此探索多条技术路线,试图把计算操作搬到存储单元内部完成。这并非全新构想,但其工程化路径远比理论复杂。
存算一体不是单一技术,而是三条并行路线
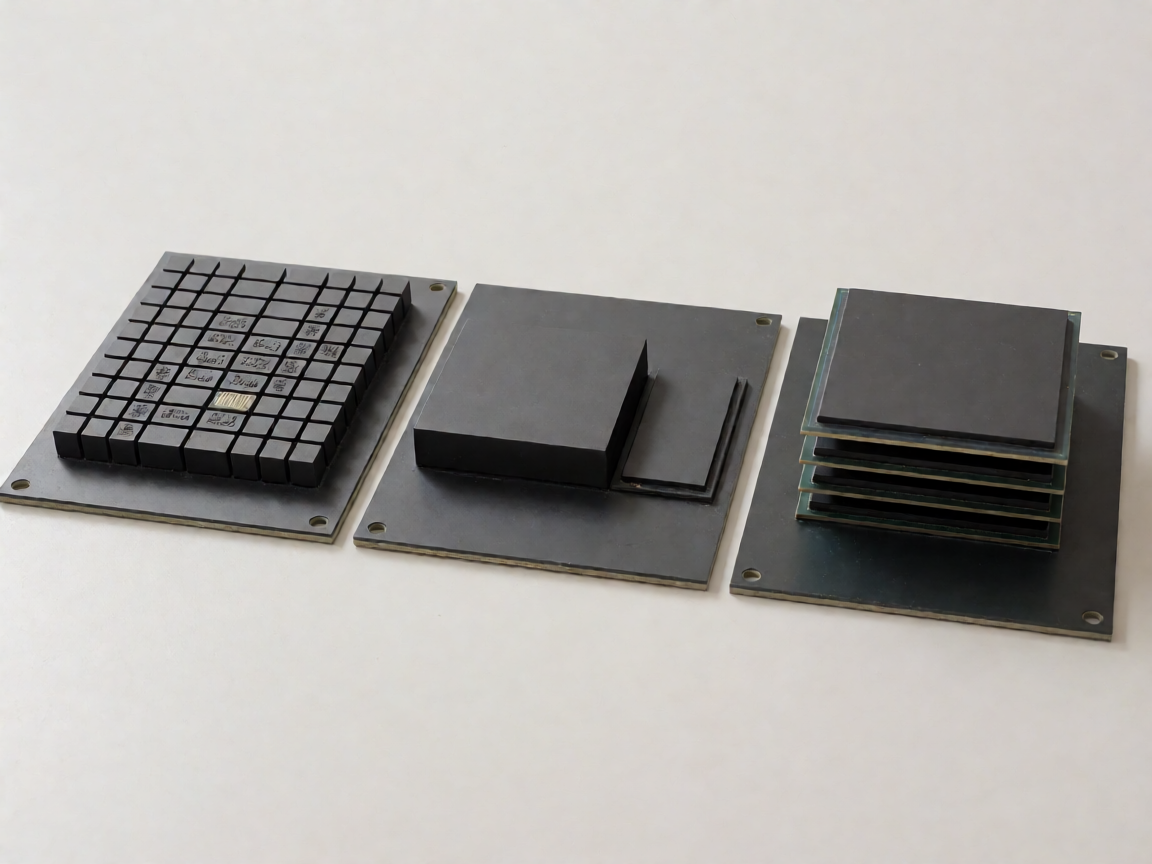
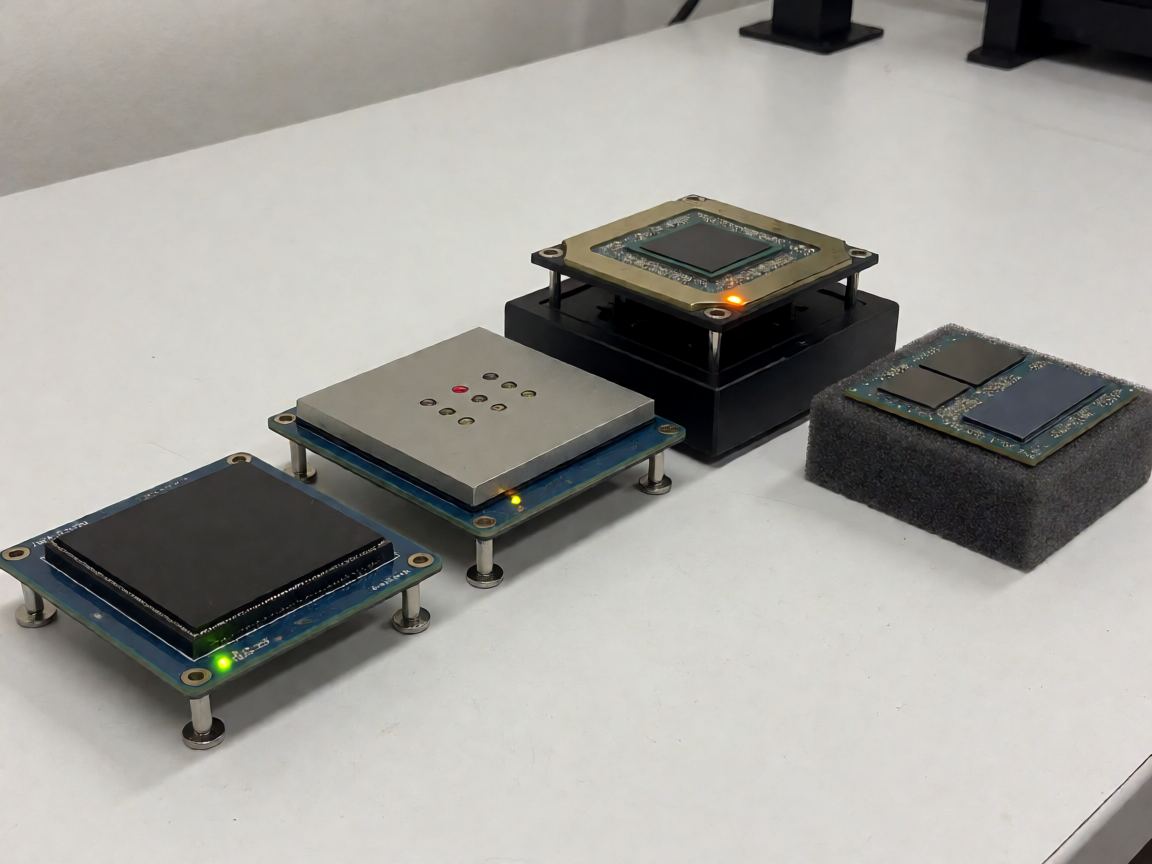
业界讨论存算一体时,往往把它当作一个整体概念。实际上存在三种截然不同但目标一致的实现方式:存内计算、近存计算和异构集成方案。
| 路线 | 核心思路 | 典型存储介质 | 主要挑战 |
|---|---|---|---|
| 存内计算 | 在存储单元内部直接执行算术运算 | ReRAM / PCM / MRAM | 器件一致性、计算精度受限 |
| 近存计算 | 将轻量计算单元置于存储芯片旁边 | SRAM / HBM + 小型逻辑 | 工艺整合复杂度、面积开销 |
| 异构集成 | 用先进封装将存储和逻辑堆叠 | 任何存储 + 逻辑Die | 热管理、封装成本 |
这三种路线的工程难度和商业可行性差异很大。存内计算在学术文章中最多,但在量产上最困难;近存计算已有产品出现,但效率提升有限;异构集成最快落地,但本质上是系统级方案而非器件级突破。
存内计算:最激进也最困难的路线
存内计算的原理是利用存储单元本身的物理特性直接完成数学运算。以ReRAM为例,多个电阻单元构成交叉阵列,电流通过阵列时自然产生基尔霍夫定律下的累加效果,相当于模拟域中的矩阵乘加运算。
这种方式的理论能效可以达到传统架构的数十倍甚至百倍以上。但前提是器件必须高度一致——同一批次中每个单元的阻值偏差不能超过百分之几,否则计算结果会完全失真。
近存计算:工程上最可行的中间路线
近存计算不追求把计算塞进存储单元,而是在存储芯片旁边集成少量逻辑单元。这样数据不需要跨越整个芯片去处理器,只需在存储模块内部完成部分预处理,再传给主处理器。
目前市面上一些AI推理芯片采用的方案属于这一类:在HBM或SRAM旁边放置小型计算核心,减少数据搬运距离,而不是彻底消除搬运。
三条路线各自的器件物理机制
理解存算一体的难点,首先要理解它依赖的三种非易失性存储介质的物理机制。它们不是同一种技术,各自有明确的适用边界。
ReRAM:电阻随机存取存储器
ReRAM的核心是一个电阻开关结构,通常由上下两个电极和中间的阻变层组成。电压作用下,阻变层中形成导电细丝或改变其构型,从而在高阻态和低阻态之间切换。
ReRAM的优点是写入速度较快(纳秒级)、结构简单、与CMOS工艺兼容性较好。主要问题是耐久性——典型循环次数在10^6到10^8之间,远低于SRAM的10^15以上。
在存内计算场景中,ReRAM的模拟特性可以天然支持矩阵乘加。但器件变异会导致每次运算结果有微小偏差,这对训练任务影响较小,对推理任务的精度要求则需要额外校准。
MRAM:磁阻随机存取存储器
MRAM利用磁性隧道结的电阻效应存储数据。两个铁磁层之间夹着一层绝缘势垒,当两层磁化方向平行时电阻低,反平行时电阻高。写操作通过自旋转移力矩或磁场切换完成。
MRAM的耐久性和速度表现均衡——写入速度在纳秒级,循环次数可达10^12以上,几乎不存在耐久性瓶颈。但它的单元面积比ReRAM大,且写入需要较大电流,这在大规模阵列中带来显著的功耗压力。
PCM:相变随机存取存储器
PCM利用硫族化合物材料在晶态和非晶态之间电阻差异巨大的特性存储数据。通过电流脉冲加热材料,快速冷却得到高阻的非晶态,慢速冷却得到低阻的晶态。
PCM的优势在于可以存储多比特(一个单元存2位或更多),且模拟写入窗口较宽,适合需要精确模拟阻值的存算应用。但它的写入速度和耐久性都不理想,循环次数通常在10^8到10^10量级,写入功耗也较高。
从实验室到产品:谁的进度最快
存算一体芯片的研发已进入产业化阶段,但不同路线的成熟度差异显著。
ReRAM路线以Visionic、Everspin等公司的产品为代表,已在部分物联网和边缘推理场景中实现小规模量产。这些芯片主要面向低功耗图像识别和传感器处理任务,而不是通用计算。
MRAM路线的产业化进度最为成熟。Everspin的MRAM芯片已进入消费电子和工业控制领域,虽然它们目前主要用于非易失性缓存而非存内计算,但工艺平台的积累为未来的存算一体MRAM奠定了基础。
PCM路线的产业化相对滞后。Intel曾投入大量资源研发3D XPoint技术(即Optane内存),但最终因商业回报不及预期而放缓。PCM在存算一体方向的探索仍在学术和部分初创公司中进行。
不同应用场景的路线匹配
- 边缘AI推理:ReRAM存内计算最具潜力,因为其低功耗和矩阵运算的天然匹配
- 高频交易和工业控制:MRAM的近存缓存方案已可商用,延迟和耐久性优势明显
- 大规模数据存储:PCM的多比特能力和仿真真模拟存储仍有研究价值,但短期内难有商业突破
- 系统级异构集成:台积电CoWoS、Intel Foveros等封装技术让”存算分离但靠近”的方案最快落地
存算一体的局限和尚未解决的问题
尽管前景明确,存算一体芯片的产业化仍面临多重结构性障碍。
器件一致性是存内计算最大的物理障碍。同一晶圆上不同位置的ReRAM单元阻值偏差可达10%至20%,这对高精度计算是不可接受的。现有方案通过芯片级校准和冗余设计来补偿,但会增加设计和制造复杂度。
精度限制是第二条路线的物理边界。模拟存算本质上是一种近似计算,适合神经网络中容忍精度损失的应用,但不适合需要精确算术的场景。要覆盖更广泛的计算任务,混合精度或数字混合方案是必要的研究方向。
制造工艺是第三条障碍。ReRAM和PCM都需要额外的工艺步骤,与现有CMOS产线的兼容性仍在验证中。大规模量产的成本优势尚未得到验证。
软件生态的缺失是最被低估的挑战。现有编译器、编程模型和调试工具全部围绕冯·诺曼架构设计,存算一体芯片需要全新的软件栈支持,这需要产业界和学术界的长期投入。
短期内的现实图景:近存和异构集成先行
综合当前技术成熟度和商业化进度,存算一体的现实路径是:近存计算和异构集成方案在未来两到三年内持续扩大应用,存内计算在特定边缘AI场景中逐步渗透。
对于终端用户而言,最直接的影响是低功耗AI设备的普及——摄像头、传感器节点、可穿戴设备将能够本地处理更多信息,减少对云端算力的依赖。这对于隐私保护和实时响应场景具有重要意义。
对于半导体行业而言,存算一体代表了一条绕开传统制程 Scaling 极限的新路径。当晶体管微缩的成本越来越高,在架构层面寻找能效提升空间变得更具吸引力。
接下来值得关注什么
存算一体领域的关键变量有几个。首先是器件一致性的工程解决方案——如果能通过工艺改进或电路设计将阻值偏差控制在5%以内,ReRAM路线将迎来实质性突破。
其次是软件工具链的成熟速度。编译器和调试工具的完善程度,将决定存算一体芯片能覆盖多大范围的应用场景。
第三是封装技术的进步。更薄更密的存储-逻辑堆叠,可能在不改变器件物理特性的前提下,大幅提升系统级能效。
存算一体不是对冯·诺曼架构的替代,而是在特定场景下对其效率缺陷的补充。理解它的边界,比盲目乐观更有价值。
总结
存算一体芯片是一条正在从实验室走向产业化的技术路线,但它不是单一技术而是三条并行的工程路径。ReRAM在边缘AI推理场景中潜力最大,但器件一致性和耐久性仍是悬而未决的问题;MRAM工艺最成熟,但目前主要应用于缓存而非真正的存内计算;PCM多比特存储特性有学术价值,但产业化进度最慢。
短期内,近存计算和异构集成方案将率先扩大应用范围,为用户带来低功耗边缘AI设备的普及。长期来看,存算一体能否真正改变计算架构,取决于器件物理、制造工艺和软件生态三条线的同步突破。
以实际结果为准,操作前请核对官网版本、授权和安全提示。
欢迎留下你的观点,成为第一个参与讨论的人。