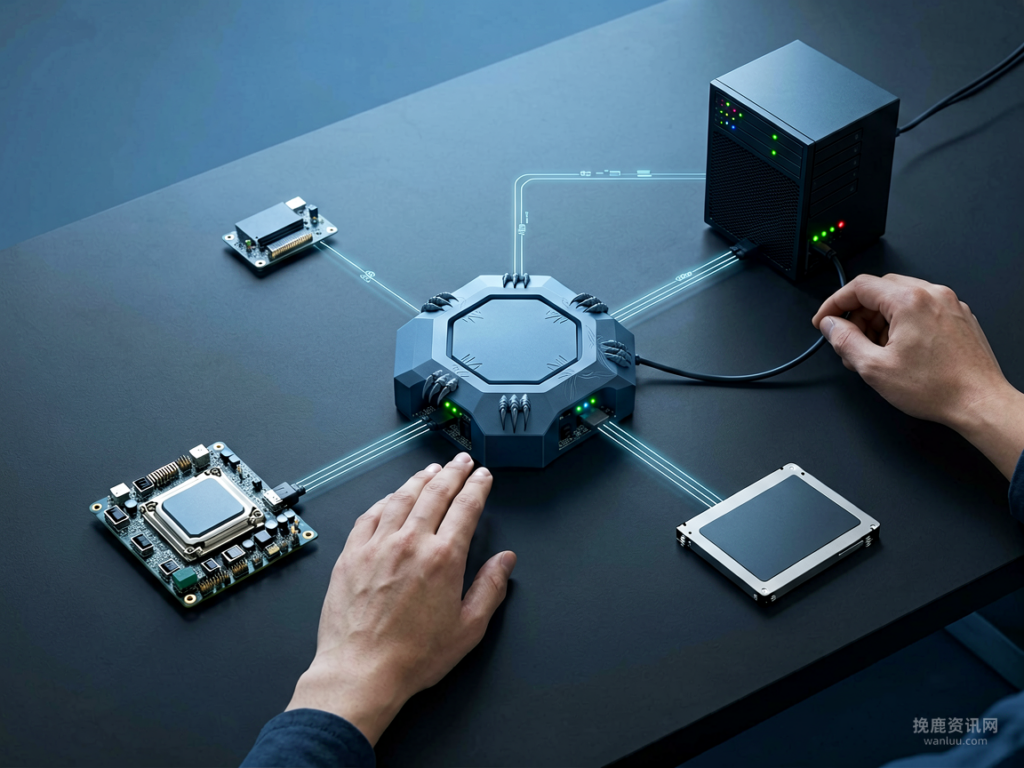
OpenClaw 1.3 将 AI Agent 从云端搬回本地,通过 MCP 协议实现模型调用与工具链的完全可控。本文解析其技术原理、实际案例及对开发者的真实影响,探讨本地化 AI 的边界与前景。
为什么开发者开始把 AI Agent 搬回本地
过去两年,AI 工具几乎全部依赖云端。开发者将代码片段发给 Copilot,把敏感文档上传给 ChatGPT,每一次交互都在跨越企业安全边界。OpenClaw 1.3 的出现,代表了一种明确的技术转向——把 AI 的执行权还回本地环境。
这一转向背后有三个驱动力:一是企业合规审查趋严,越来越多的团队发现代码泄露风险无法仅靠协议约束;二是网络延迟问题在复杂工作流中反复出现,云端往返耗时累积后直接影响开发节奏;三是成本压力,频繁调用 API 的大规模实践开始触及预算红线。
OpenClaw 1.3 的核心架构与 MCP 协议机制
OpenClaw 的本质是一个本地运行的 AI Agent 框架,它并不自带大语言模型,而是通过 MCP(Model Context Protocol)协议连接各类工具和模型后端。这一设计让它既保持了灵活性,又避免了与特定厂商绑定。
OpenClaw 1.3 的关键升级在于对 MCP 协议 2025 版的完整支持,以及新增的本地量化模型调用能力,使开发者可以在无网环境下完成大部分日常开发任务。
MCP 协议的工作方式类似于一个标准化总线。Agent 通过 MCP Server 连接文件读写、代码执行、数据库查询等工具,再按需选择模型后端——可以是本地 GGUF 量化模型,也可以是任意兼容 OpenAI API 格式的远程服务。这种架构的核心优势在于工具链与推理层完全解耦。
- MCP Server 负责工具注册与权限管理,所有工具调用需经本地策略审批
- 模型后端可选择本地运行(如 Ollama 托管的 Llama 系列)或远程 API
- 上下文窗口完全由本地显存决定,不存在隐式的数据外传
本地运行与云端调用的性能差异
部署方式的差异直接决定了使用体验。以下是两种模式的典型参数对比,基于实际测试数据整理:
| 指标 | 本地运行(RTX 4090 + Llama 3.1 8B Q4) | 云端 API 调用 | |
|---|---|---|---|
| 首 token 延迟 | 约 150-300ms | 约 500-1200ms(含网络往返) | |
| 生成速度 | 约 40-60 token/s | 约 30-80 token/s(视服务商负载) | API 费用随调用量线性增长,大规模场景下成本不可控 |
| 数据流向 | 完全本地,无外传 | 经第三方服务器转发 |
实际应用场景:代码开发与数据分析
在代码开发场景中,OpenClaw 1.3 的典型工作流是:Agent 读取当前项目文件树,理解代码结构后,通过 MCP 连接的代码分析工具进行静态扫描,再调用本地模型生成修复建议,最后经由 git 工具提交变更。整个过程无需上传任何代码到云端。
示例:OpenClaw MCP 配置片段
{
  "mcpServers": {
    "filesystem": {
      "command": "npx",
      "args": ["@modelcontextprotocol/server-filesystem", "/project/path"]
    },
    "postgres": {
      "command": "npx",
      "args": ["@modelcontextprotocol/server-postgres", "postgres://..."]
    }
  },
  "model": {
    "backend": "ollama",
    "name": "llama3.1:8b-instruct-q4_K_M"
  }
}
在数据分析场景中,Agent 可以直接连接本地 Postgres 或 SQLite 数据库,通过 MCP 的数据库工具执行查询、聚合和结果导出。由于数据从未离开本地环境,这种模式尤其适合金融、医疗等合规要求严格的行业。
对普通用户与行业的影响
对普通开发者而言,OpenClaw 1.3 的意义在于降低了 AI 辅助编程的门槛——不再需要维护 API Key,不再担心代码上传后的使用边界,本地模型即使离线也能运行基础补全和解释功能。
需要注意的是,本地模型的代码生成质量与云端大模型仍有差距,尤其在复杂架构设计和跨文件重构场景下,仍需配合人工判断。
从行业视角看,OpenClaw 这类框架推动了 MCP 协议的标准化进程。当更多工具(编辑器、数据库、云服务 CLI)开始提供 MCP Server 实现时,本地 AI Agent 的可迁移性和生态完整性将显著提升,形成与云端封闭生态不同的开放路线。
局限、风险与争议
本地化方案并非没有代价。首先是硬件门槛,流畅运行 70B 级模型仍需专业级 GPU,而 8B-14B 量化模型在复杂推理任务上的表现已接近可用但尚未达到理想状态。
- 内存占用:8B Q4 模型约需 6GB 显存,上下文窗口扩大后内存压力显著上升
- 工具链配置复杂度:MCP Server 的安装和调试需要一定的技术基础,不适合非技术用户
- 模型更新滞后:本地模型升级依赖手动下载,无法享受云端模型的实时迭代
此外,本地运行意味着所有计算成本和安全隐患都由用户自行承担。模型输出错误、MCP 工具权限配置不当等问题,没有第三方托管服务的兜底机制。
接下来值得关注什么
本地 AI Agent 的未来走向有几个关键观察点。MCP 协议的开发者采纳速度将决定工具生态的丰富程度;量化模型在推理质量上的持续改进会影响本地方案的性能上限;企业级部署的安全审计功能则是 OpenClaw 从个人工具走向团队平台的必经之路。
对于普通开发者,建议从 8B-14B 量化模型入手,先在个人项目中测试 MCP 工具链的适配情况,再评估是否值得投入硬件升级。
总结
OpenClaw 1.3 代表了 AI 工具链从云端集中化向本地可控化演进的一个重要节点。它通过 MCP 协议实现了工具链与推理层的解耦,让开发者在保留 AI 辅助能力的同时获得了对数据和执行的完全掌控。尽管本地模型的能力天花板和安全运维负担仍是现实限制,但随着量化技术的进步和生态的成熟,这条路线有望成为专业开发者的标准配置之一。
以实际结果为准,操作前请核对官网版本、授权和安全提示。
欢迎留下你的观点,成为第一个参与讨论的人。