
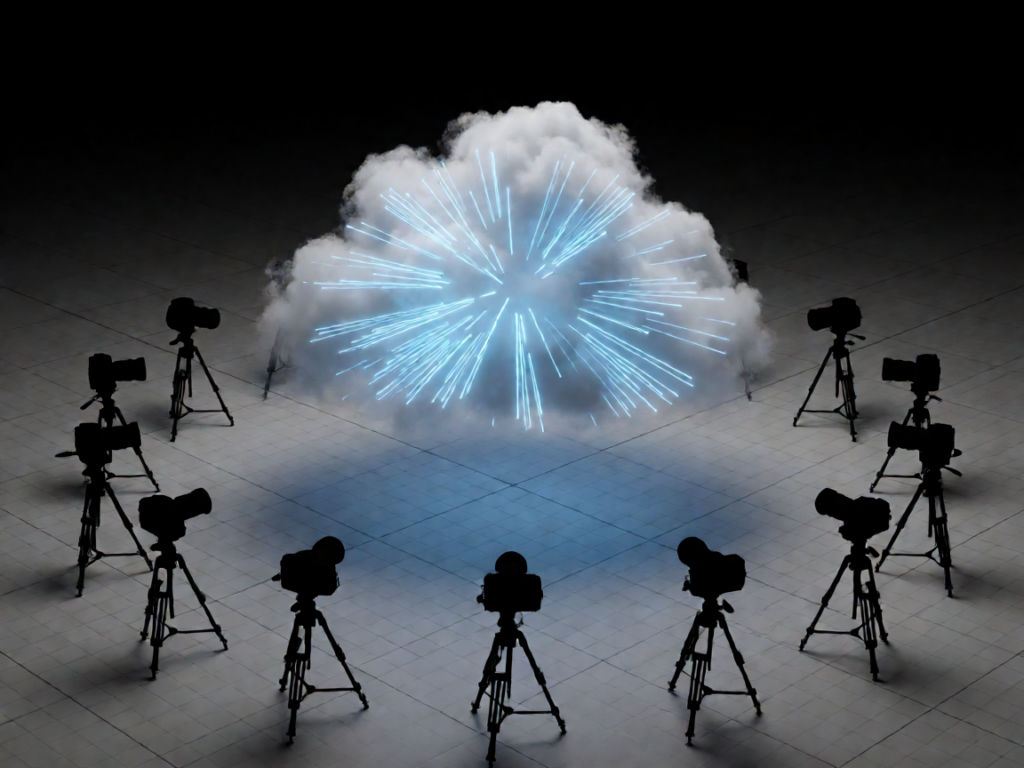
神经辐射场(NeRF)通过神经网络学习场景的连续体积函数,从多角度照片重建可自由视角的三维场景。本文解析其编码机制、渲染原理、与3DGS的技术分野及真实应用边界。
核心结论:NeRF让照片学会「思考深度」
神经辐射场(NeRF)的核心突破不在于拍摄更高分辨率的照片,而在于用神经网络学习了场景的连续体积表示。传统三维重建依赖密集的激光扫描或结构光,NeRF只需几张到几十张照片即可重建出具有真实光照和几何信息的三维场景,并支持任意视角的新图像合成。
这项技术的真正价值在于它将三维几何与渲染合二为一——网络同时输出空间位置和颜色密度,从而在隐式表示中保留完整的渲染信息。尽管训练耗时仍是主要瓶颈,但NeRF开创了一条不依赖显式网格的三维感知新路径。
技术背景:从多视图立体匹配到隐式表示
在NeRF之前,三维重建的主流方法是多视图立体匹配(MVS)。该方法通过提取多张图像的特征点并进行视差计算,最终生成稀疏或密集的三角网格点云。MVS技术成熟、推理速度快,但在纹理缺失区域(如白墙、玻璃)会产生空洞,且无法还原连续的光照和材质变化。
2020年,MIT等人发表的NeRF论文提出了一种完全不同的思路:用多层感知机(MLP)隐式编码场景。网络接收空间坐标和观测方向作为输入,直接输出该点的体积密度和视角相关的颜色。这种方法跳过了显式的网格生成环节,转而让神经网络在连续空间中学习场景的辐射场。
原理机制:体积渲染与坐标编码
体积渲染的基本公式
NeRF的渲染过程沿每条从相机出发的光线采样多个点,每个点通过网络预测密度σ和颜色c。最终像素颜色由体积渲染公式计算:
c(r) = Σ t_i · σ_i · c_i · exp(-Σ σ_jΔ_j)
其中r为光线参数,t_i为累积透射率。该公式的物理含义是:光线上每一点的贡献取决于该点的密度、颜色和前方所有点的遮挡程度。通过反向传播优化这一渲染方程,网络逐步学习到场景的几何和外观。
位置编码:解决MLP的低频偏好
普通MLP在学习高频细节时存在天然偏差,难以精确编码三维场景中的尖锐几何结构。NeRF引入位置编码(Positional Encoding),将原始坐标(x,y,z)和视角方向(θ,φ)映射到高维空间,通过正弦函数扩展特征频率。这使得网络能够同时捕捉场景的大尺度结构和微细纹理。
关键机制总结
- 隐式体积表示:MLP将连续空间坐标映射为密度和颜色
- 体积渲染:沿光线积分合成像素颜色,保留遮挡关系
- 位置编码:正弦特征扩展使网络能学习高频几何细节
- 视角依赖:颜色输出包含反射属性,支持真实感新视角合成
实际应用:从学术研究到产业落地
NeRF自提出后迅速渗透至多个领域。在文化遗产数字化中,学者利用NeRF从少量照片重建古建筑和文物的三维场景,精度可达亚毫米级。相比传统摄影测量,NeRF在纹理重复区域的表现显著更优,减少了人工修复的工作量。
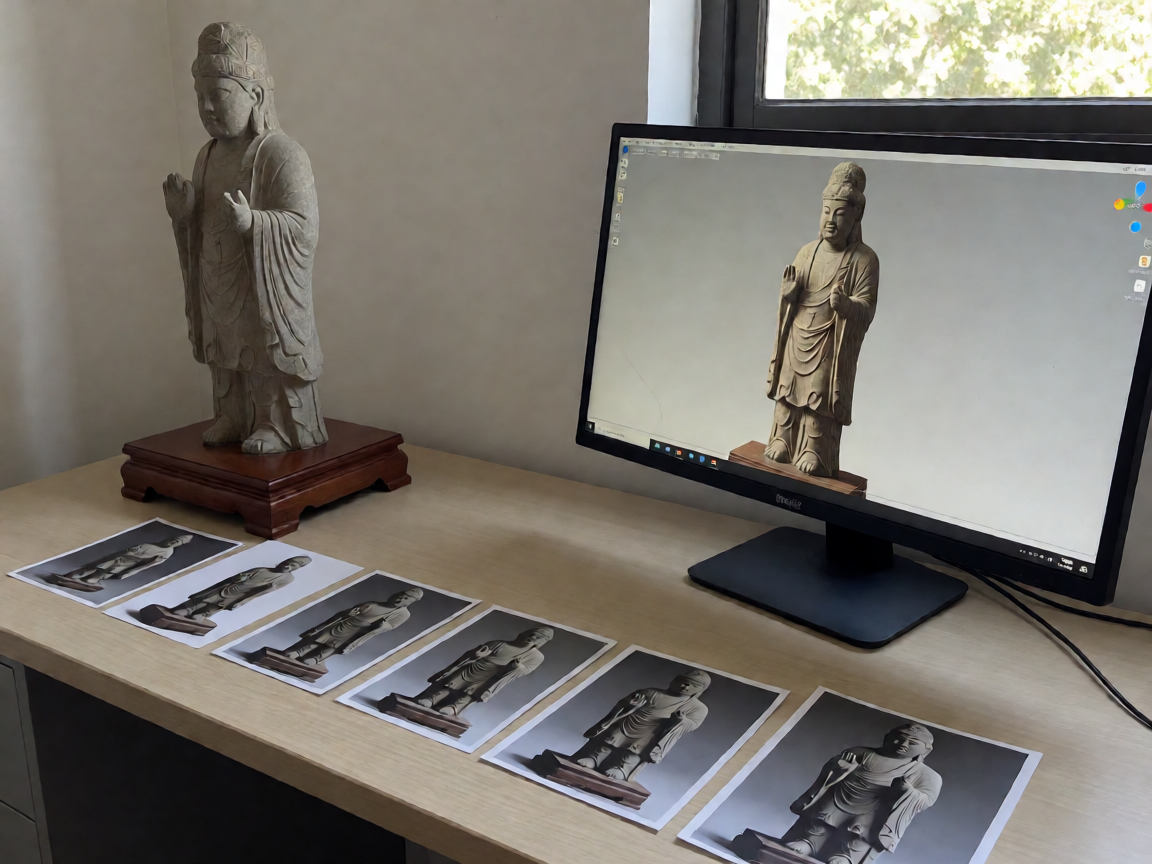
影视与游戏行业是NeRF的另一重要应用场景。制片团队使用NeRF快速生成虚拟布景的新视角图像,减少了实拍时的灯光和机位限制。在游戏开发中,NeRF被用于从实景照片生成可交互的三维环境资产,大幅缩短了场景制作周期。
| 应用领域 | NeRF优势 | 典型输入数据 |
|---|---|---|
| 文化遗产数字化 | 亚毫米级精度,纹理还原真实 | 50-200张高清照片 |
| 影视虚拟布景 | 快速新视角合成,减少实拍成本 | 10-50张参考图像 |
| 自动驾驶仿真 | 从真实街景生成多样化训练数据 | 车载摄像头序列 |
| 工业缺陷检测 | 三维表面细节的高保真重建 | 多角度工业相机 |
产业影响:重新定义三维数据采集方式
NeRF对产业的影响首先体现在数据采集成本的降低。传统三维重建需要专业激光扫描仪或多传感器采集设备,NeRF仅需普通相机即可获取同等质量的三维表示。这使中小型企业和个人创作者也能进行高质量三维内容生产。
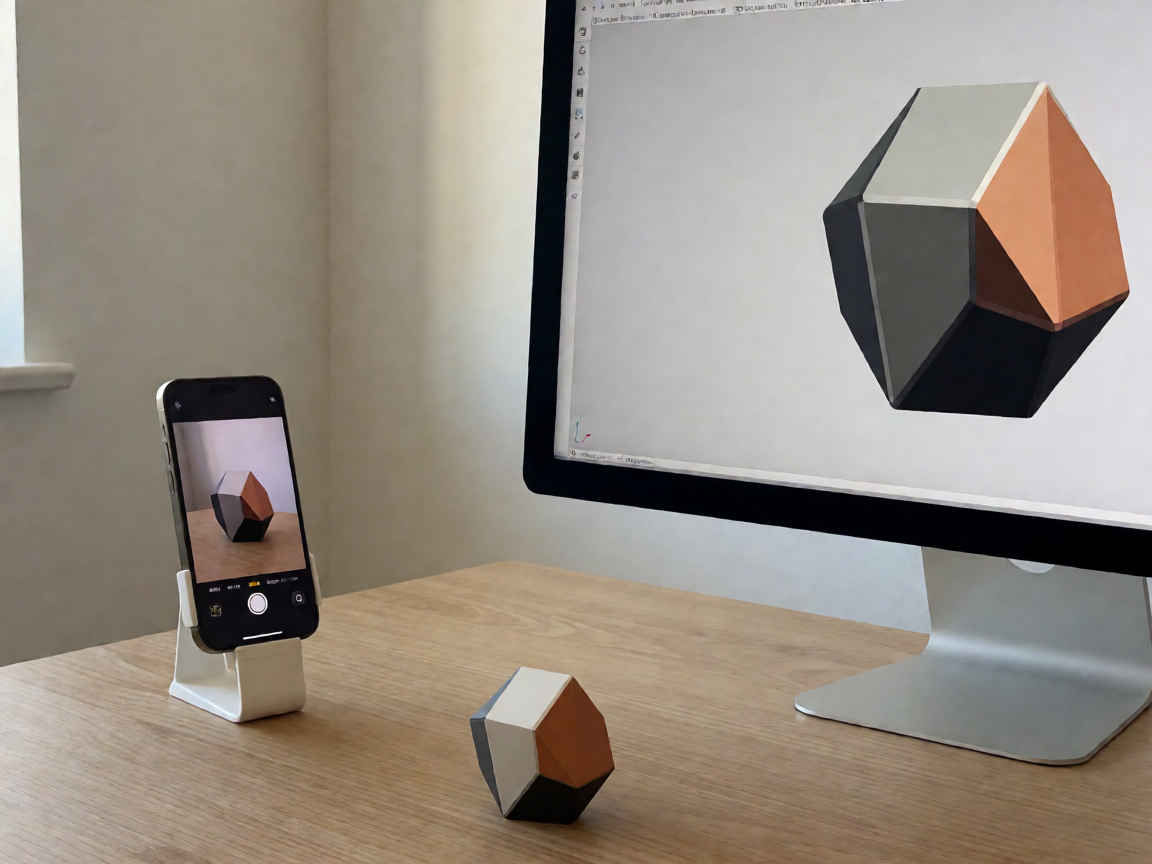
其次,NeRF催生了新的内容形态。即时神经辐射场(Instant NGP)将训练时间从数小时压缩至数秒,使三维重建可以嵌入移动端和Web端应用。用户通过手机扫描房间即可生成可漫游的三维模型,这一能力正在改写房地产展示、室内设计咨询和电商商品展示的交互模式。
NeRF带来的产业范式转变
三维数据采集从「设备驱动」转向「算法驱动」——同样的物理场景,不同算法可以产出质量差异巨大的三维结果。这意味着软件能力正在取代硬件投入,成为三维内容生产的决定性因素。
局限与风险:训练成本、泛化能力与存储开销
训练效率的持续优化
尽管Instant NGP大幅缩短了单场景训练时间,但NeRF在处理大规模场景时仍面临挑战。城市级三维重建需要数百GB的训练数据和数小时的GPU时间,这一成本限制了其在实时应用中的普及。
泛化能力的边界
标准NeRF针对特定场景训练,泛化到新场景需要重新训练网络。虽然近期研究提出了泛化NeRF(Generalizable NeRF)的概念,通过预训练网络从少量图像推断场景参数,但其在复杂光照和动态场景下的表现仍不稳定。
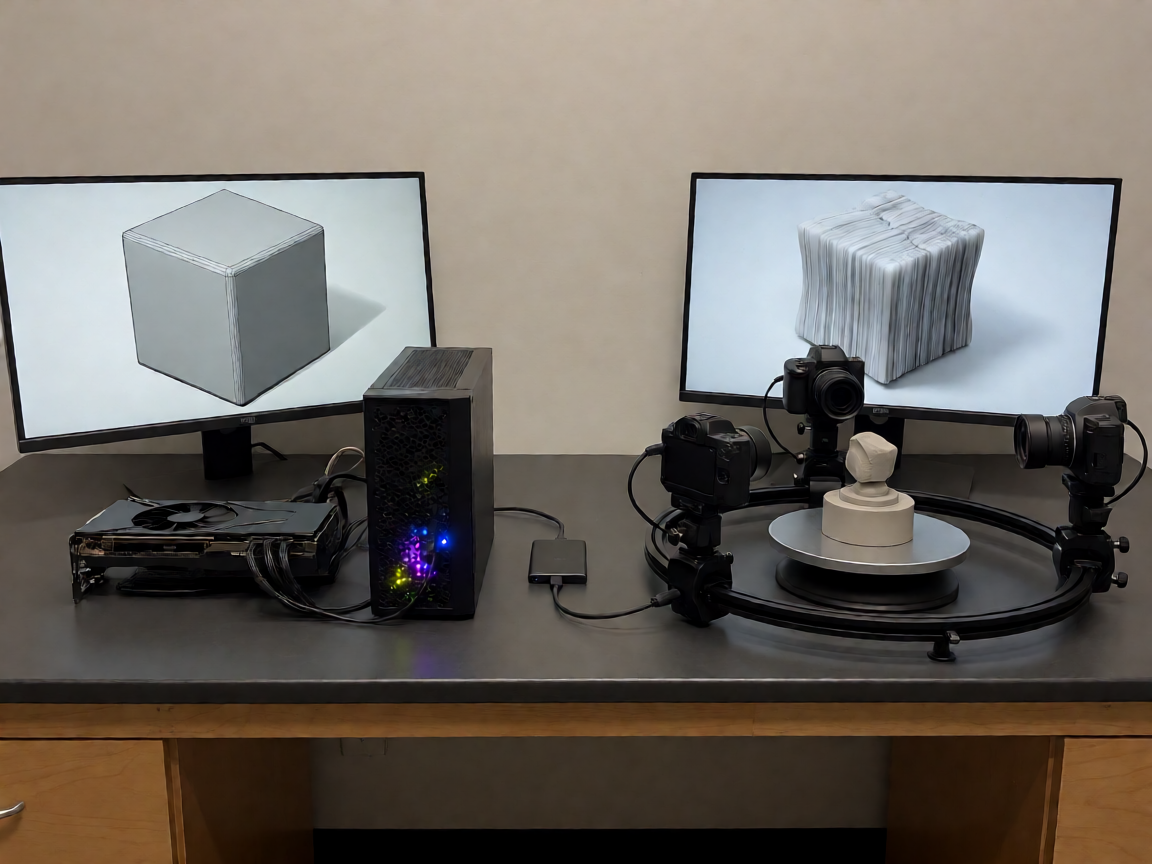
- 训练耗时:单场景通常需要数小时GPU时间,Instant NGP可降至秒级但仅适用于中等规模场景
- 存储开销:网络权重文件通常在10-100MB,大规模场景的隐式表示仍需额外数据压缩
- 动态场景限制:标准NeRF假设场景静态,运动物体的重建会产生伪影和模糊
- 稀疏视角盲区:输入照片少于10张时,重建质量显著下降,几何结构可能出现伪影
后续观察:3D Gaussian Splatting与NeRF的融合趋势
2023年提出的3D Gaussian Splatting(3DGS)在渲染质量和实时性能上全面超越了NeRF,但其本质上仍受NeRF启发——同样利用体积渲染思想,只是将隐式MLP替换为显式的各向异性高斯球集合。3DGS将训练时间压缩至分钟级,实时渲染帧率可达60fps以上。
当前的技术趋势显示,NeRF与3DGS正在走向融合:NeRF提供高质量的隐式先验,3DGS提供高效的显式表示。这种混合方案有望在保持重建精度的同时,解决存储和渲染效率的瓶颈。未来几年,三维重建技术的竞争将集中在大规模场景处理能力、动态场景适应性以及跨平台部署效率三个维度。
技术对比:NeRF vs 3D Gaussian Splatting
| 维度 | NeRF | 3D Gaussian Splatting |
|---|---|---|
| 训练时间 | 数小时(Instant NGP秒级) | 数分钟 |
| 渲染帧率 | 实时需后处理 | 60fps+ 原生实时 |
| 存储空间 | 网络权重10-100MB | 高斯参数10-50MB |
| 动态场景 | 不支持 | 部分支持(4D Gaussian Splatting) |
| 几何精度 | 高(连续隐式表示) | 中高(离散近似) |
总结:NeRF的价值不在替代,而在启发
神经辐射场的真正意义不在于其能否在实际生产中长期主导三维重建,而在于它证明了神经网络可以学习连续的三维场景表示。这一认知突破催生了3D Gaussian Splatting、Instant NGP等一系列后续工作,推动整个三维视觉领域进入高速发展期。
对于行业从业者而言,NeRF的核心启示是:三维数据的采集、处理和渲染正在从传统的几何管线转向基于学习的隐式管线。理解NeRF的原理,有助于把握下一代三维内容生成工具的设计逻辑和应用边界。无论未来技术路线如何演进,NeRF奠定的体积渲染框架都将成为三维视觉的基础设施。
以实际结果为准,操作前请核对官网版本、授权和安全提示。
欢迎留下你的观点,成为第一个参与讨论的人。