
存内计算被寄予厚望,但三种主流非易失性存储器的物理机制、工艺成熟度和产业化路径差异显著。本文梳理RRAM、MRAM、FeRAM的工程逻辑与应用边界,揭示为何「存算一体」尚未跨越量产门槛。
存内计算的核心承诺与物理现实
存内计算试图打破冯·诺曼架构的「内存墙」,让计算直接在存储器内部完成,而非将数据搬运至CPU或GPU。这一思路的理论收益明确:能耗可降至传统方案的1%至10%,延迟降低两个数量级,尤其适合边缘AI推理和物联网节点。
然而,理论收益向工程落地的转化,卡在存储器介质的选择上。RRAM(阻变存储器)、MRAM(磁阻存储器)和FeRAM(铁电存储器)三条技术路线各有物理机制,也各有产业化瓶颈。本文不讨论通用DRAM或Flash,只聚焦这三种被寄予「存算一体」厚望的非易失性存储器。
核心判断:存内计算的瓶颈不在架构创意,而在存储器介质能否同时满足高密度、低功耗、长寿命和CMOS兼容性四个工程条件。目前三种路线均未全面达标,量产时间点持续推迟。
RRAM的物理机制:导电细丝的不可控形成
RRAM基于金属氧化物(如HfO₂、TaOₓ)在电场作用下形成或断裂导电细丝,实现低阻态(LRS)和高阻态(HRS)的可逆切换。其物理机制简单,单元面积可做到2F²(F为最小特征尺寸),理论密度接近DRAM。
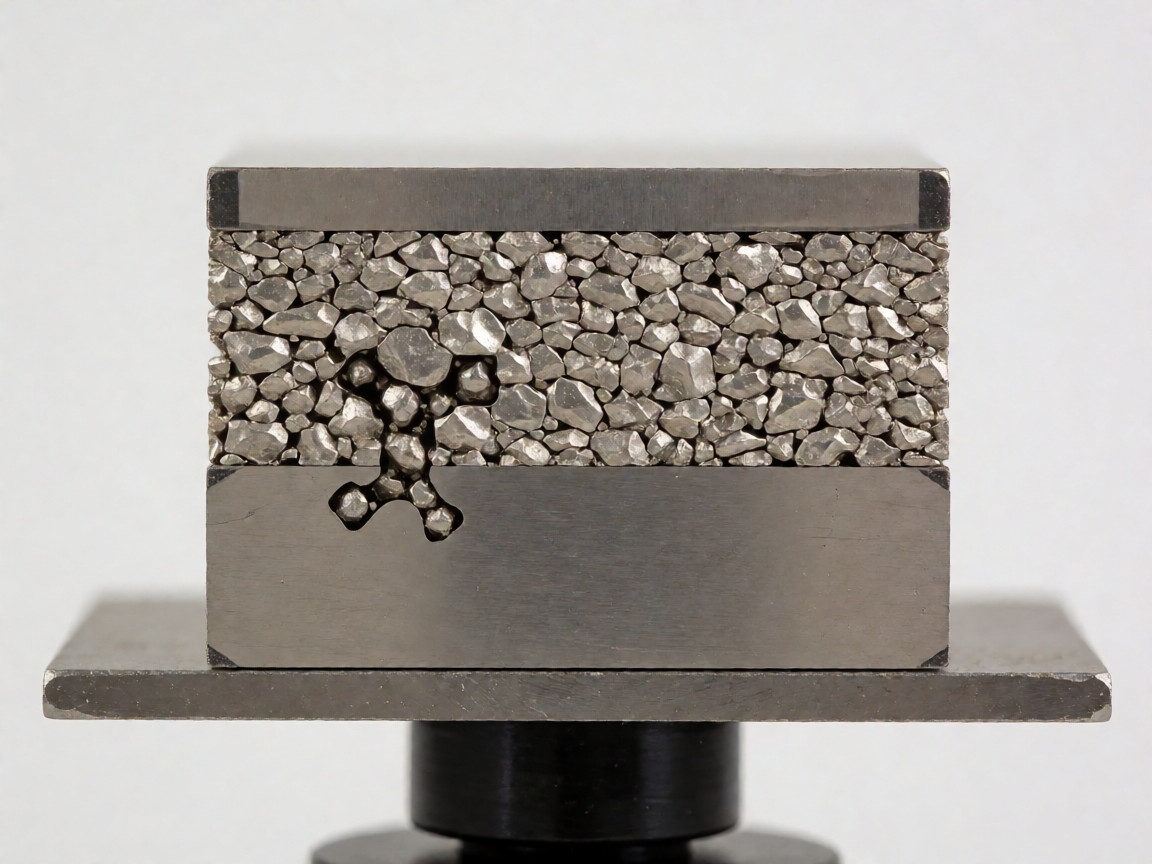
但导电细丝的形成是随机过程,受缺陷分布、电场集中和热效应共同影响。同一批次不同单元的阈值电压分布宽,导致写入精度难以控制。更关键的是,细丝断裂不完全或过量生长会引发漏电或短路,循环寿命通常在10⁶至10⁸次,远低于Flash的10⁵次但无法胜任高频训练场景。
| 参数 | RRAM典型值 | 工程挑战 |
|---|---|---|
| 单元面积 | 2F² | 细丝随机性导致良率波动 |
| 写入能耗 | 10-100 fJ/bit | 脉冲形状需精确控制 |
| 循环寿命 | 10⁶-10⁸ | 细丝疲劳断裂不可预测 |
| 数据保持 | >10年(室温) | 高温下退火效应加速失效 |
学术界已演示RRAM存算阵列用于矩阵乘加,但阵列规模通常限于64×64至256×256,远未达到商业芯片所需的兆级规模。工业界尝试通过堆叠(3D RRAM)提升密度,但层间对准和电流分布均匀性仍是未解工程问题。
MRAM的磁隧穿机制:稳定性与速度的天然矛盾
MRAM利用磁性隧道结(MTJ)的隧穿磁阻效应:两层铁磁层(如CoFeB)被MgO势垒隔开,相对磁化方向决定电阻高低。其写入机制分两类——STT-MRAM(自旋转移矩)用自旋极化电流翻转自由层,SOT-MRAM(自旋轨道矩)用面内电流产生横向自旋力。
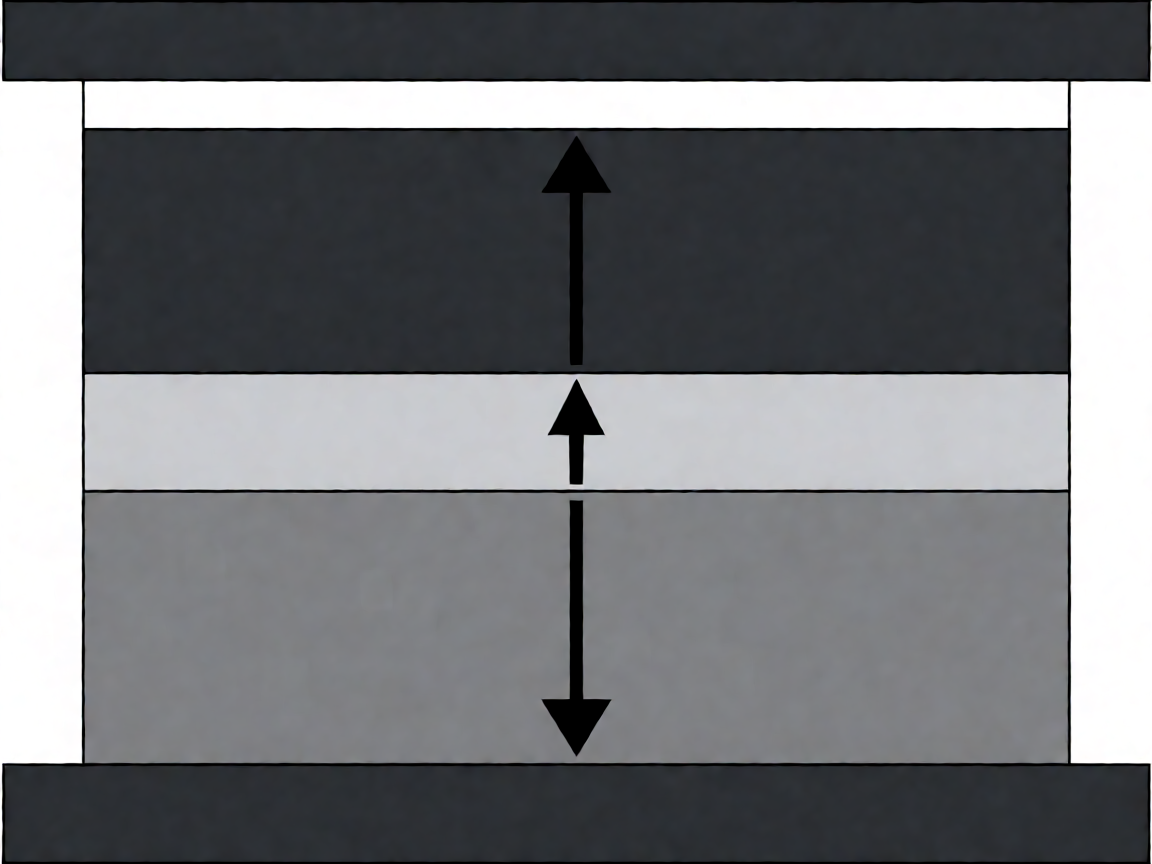
MRAM的优势在于近乎无限的循环寿命(>10¹⁵次)和纳秒级写入速度,已用于CPU缓存和MCU代码存储。但写入电流密度高(>10⁶ A/cm²),导致功耗难以低于RRAM;单元面积通常4F²至6F²,密度不及RRAM。
关键机制矛盾:MRAM需要足够大的磁各向异性维持数据稳定性,但高各向异性又要求更大写入磁场或电流,形成「稳定性-写入能耗」的零和博弈。这是物理限制,非工艺优化可完全克服。
工业界已通过材料工程(如引入氮化物界面层)将写入电流降低30%至50%,但距离存内计算所需的皮焦级能耗仍有数量级差距。目前MRAM存算原型仅验证了小规模二元分类网络,未触及大模型推理的万亿参数规模。
FeRAM的铁电极化:速度最快但密度最低
FeRAM基于铁电材料(如PZT、SBT)的极化方向存储信息:外加电场使电畴翻转,移除后极化状态保持。其写入机制是介电极化Switching,无需电荷注入或磁场生成,理论上能耗最低。
实测写入能耗可达1 pJ/bit以下,速度<10 ns,循环寿命>10¹⁴次,指标均优于RRAM和MRAM。但铁电材料的晶界缺陷和疲劳效应导致极化衰减,且PZT含铅不符合RoHS指令,SBT制备复杂、成本高,两者均难以兼容先进CMOS产线。
| 参数 | FeRAM | RRAM | MRAM |
|---|---|---|---|
| 写入能耗 | <1 pJ/bit | 10-100 fJ/bit | 10-100 fJ/bit |
| 单元面积 | 6F²-8F² | 2F² | 4F²-6F² |
| 循环寿命 | >10¹⁴ | 10⁶-10⁸ | >10¹⁵ |
| 密度潜力 | 低 | 高 | 中 |
FeRAM的致命伤是密度。铁电电容需要较大电极面积以维持极化强度,单元尺寸无法缩小至4F²以下。这与存内计算所需的高密度阵列相悖——若每单元能耗低但占用面积大,系统级功耗反而更高。
三种路线横向对比:取舍框架
密度 vs 寿命 vs 能耗三角矛盾
三种技术在同一维度上呈现此消彼长关系:RRAM密度最高但寿命最短;MRAM寿命最长但能耗偏高;FeRAM能耗最低但密度最差。存内计算阵列通常要求百万级以上单元,密度不足直接导致面积膨胀和成本上升。
制程兼容性评估
RRAM与现有CMOS产线兼容度最高,仅需在BEOL(后端工艺)增加金属氧化物沉积步骤;MRAM需要在MTJ溅射和刻蚀环节引入额外流程,对产线改造要求较高;FeRAM因PZT含铅问题,在先进制程中几乎无法兼容RoHS合规要求。
存算精度需求匹配
RRAM电导量化级数约3-4 bit,适合INT4/INT8量化的低精度推理;MRAM写入精度高但模拟开关噪声较大,更适合数字存算混合架构;FeRAM极性保持稳定,量化精度可达5 bit以上,但阵列规模受限。
存算一体的工程路径:从阵列到系统
存内计算需跨越三道工程门槛:第一道是器件一致性,阵列内百万级单元的参数分布必须收敛;第二道是模拟精度,电导值量化级数需≥4 bit才能支撑AI权重表示;第三道是系统集成,存算阵列需与外围CMOS逻辑共享产线、封装和散热。
学术界已展示RRAM存算芯片用于ImageNet分类,能效比约10 TOPS/W,优于GPU的1-2 TOPS/W,但绝对算力仅0.1 TOPS,无法运行大语言模型。MRAM存算原型更多停留在原理验证,未进入系统级测试。FeRAM因密度限制,几乎没有存算阵列演示。
- RRAM路径:优势在密度,劣势在精度和寿命,适合低比特量化推理
- MRAM路径:优势在寿命和速度,劣势在能耗和密度,适合缓存替代
- FeRAM路径:优势在能耗和寿命,劣势在密度,适合超低功耗IoT
产业判断:短期(3-5年)存内计算不会替代通用AI加速器,而是作为协处理器嵌入SoC,用于特定低算力场景。中期(5-10年)若器件一致性突破,可能切入边缘视觉和语音识别。
量产现实的冷思考:为何推迟又推迟
存内计算的产业化推迟,根本原因是「实验室演示」与「量产良率」之间存在巨大鸿沟。学术界通常在10×10至64×64阵列上演示功能,工业量产需64Mbit至Gbit级阵列,参数分布、缺陷映射、冗余修复等工程问题呈指数增长。
另一关键瓶颈是EDA工具缺失。现有半导体设计流程围绕CMOS标准单元构建,存算混合阵列需要全新的物理综合、时序分析和功耗优化工具链,而此类工具尚未成熟。
此外,存内计算的性价比优势仅在特定负载下成立。对于训练场景,数据搬运能耗占比低(权重常驻显存),存算一体收益有限;对于推理场景,若模型精度要求高(FP16/FP32),模拟存算的量化噪声会主导误差,数字外设的计算能耗反而更优。
后续观察:哪些信号值得追踪
存内计算的下一步突破,可能来自三个方向:一是新型存储介质(如相变存储器PCM、真空纳米间隙存储器),其物理机制可能绕过RRAM/MRAM/FeRAM的既有矛盾;二是存算算法协同优化,如原生支持低比特量化的模型架构,降低对器件精度的要求;三是3D集成技术成熟,使存算阵列与逻辑层分离制造、后期键合,规避CMOS兼容性难题。
投资者和工程师应追踪的信号包括:头部Foundry是否将RRAM/MRAM纳入量产工艺节点、存算芯片流片次数和阵列规模、以及端到端应用演示是否从「分类准确度」转向「系统级延迟与能耗」。
总结:存内计算仍在上坡路
存内计算不是伪命题,其物理收益已被广泛验证。但RRAM、MRAM、FeRAM三条记忆体路线各有不可调和的工程矛盾——RRAM的精度、MRAM的能耗、FeRAM的密度——均无法单独支撑大规模商业化。短期看,存内计算将停留在利基市场(超低功耗IoT、专用视觉协处理器);中期看,需等待器件一致性突破或新型介质涌现;长期看,「存算一体」可能以异构集成方式实现,而非单片集成的浪漫想象。
对技术决策者的建议是:关注存算协同设计,而非孤立优化存储器;评估具体应用场景的能效边界,而非追逐学术演示的峰值指标;理解量产鸿沟的存在,避免将实验室结果直接外推至商业产品。
以实际结果为准,操作前请核对官网版本、授权和安全提示。
欢迎留下你的观点,成为第一个参与讨论的人。