

智能手机摄像头受限于体积,无法像单反一样靠大传感器捕捉光线。计算摄影通过HDR多帧合成、AI降噪、深度估计等算法,弥补硬件短板。本文解析其核心原理、应用场景与当前技术边界。
为什么手机摄像头越做越大,画质却依然依赖算法?
很多人有一个直觉:手机像素越来越高,照片应该越来越好。但实际情况并非如此简单。
手机内部空间极其有限,传感器尺寸通常只有全画幅相机的十分之一左右。传感器越小,单位面积接收的光子数量就越少,这是物理定律,算法无法绕过。
然而过去十年,手机摄影的能力却在快速提升。这个看似矛盾的现象,答案就藏在一个词里——计算摄影。
计算摄影不是简单地提高像素,而是用算法替代部分硬件功能,用软件弥补物理限制。
HDR多帧合成:一张照片背后的七次快门
HDR的核心机制:曝光融合而非亮度叠加
HDR(高动态范围)是计算摄影中最基础也最核心的技术之一。它解决的是手机无法同时捕捉亮部和暗部细节的问题。
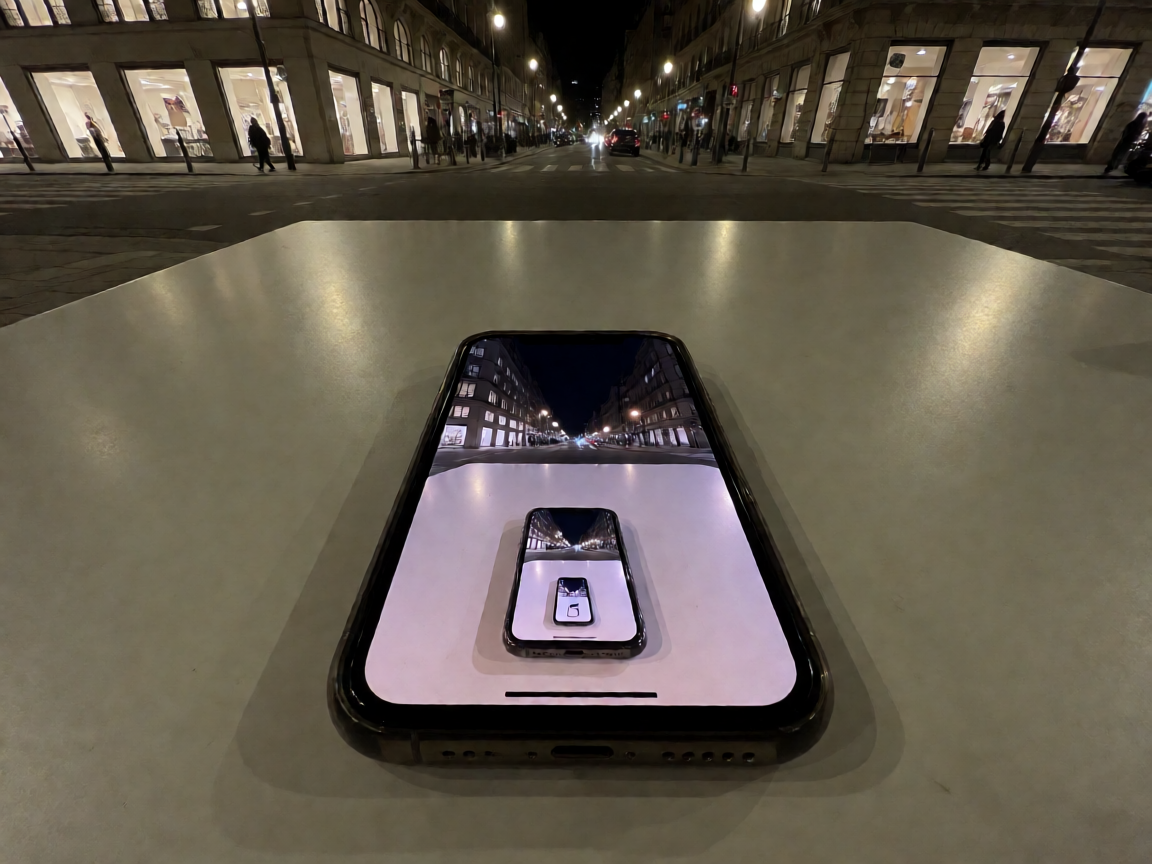
单反相机可以通过增大传感器面积来容纳更大的动态范围,而手机的做法是:在按下快门的瞬间,连续拍摄多张不同曝光时长的照片。
比如拍一张夜景灯光照片,算法会同时捕获一张短曝光(保留灯光细节)、一张正常曝光(中间调准确)、一张长曝光(暗部有内容)的照片。
然后逐像素比较这三张照片,取亮度最合适的部分拼合在一起。这个过程通常在几十毫秒内完成。
关键机制:HDR合成的核心是「曝光融合」而非简单的亮度叠加。它需要精确对齐多张照片,否则移动物体(如行人、车辆)会产生重影。现代手机的ISP(图像信号处理器)内置了实时运动补偿算法来解决这个问题。
HDR的运动补偿:避免重影的关键
在多帧合过程中,场景中的运动物体是最难处理的部分。如果对齐不够精确,移动的人物、车辆会在最终画面中产生鬼影。
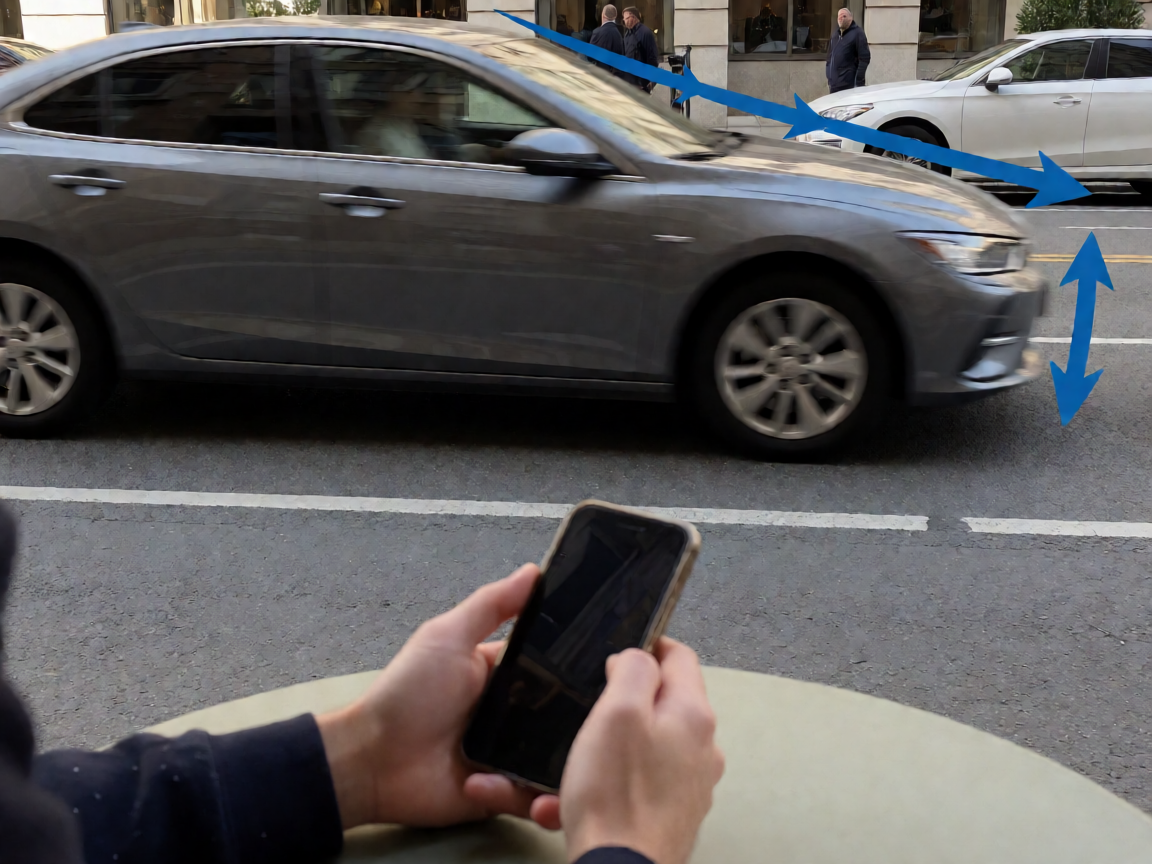
现代手机通过两种方式应对:一是在ISP层面使用光流法实时估算运动矢量,二是在合成阶段采用自适应权重分配,对运动区域降低权重或直接用最优帧替换。
小传感器的噪点困境与AI降噪的真实逻辑
传统降噪的痛点:涂抹感与细节丢失
传感器小的另一个直接后果是高ISO下的噪点问题。光线不足时,手机必须提高感光度来保证画面亮度,但小传感器的高ISO噪点远比单反严重。
早期的解决方案是用长曝光配合降噪算法,但这会带来「涂抹感」——画面看起来像油画,细节尽失。
深度学习降噪:区分细节与噪点的统计特征
现代手机采用的是深度学习降噪方案。训练数据包含大量「noisy-clean」图像对——同一场景的嘈杂照片和干净照片作为输入输出。
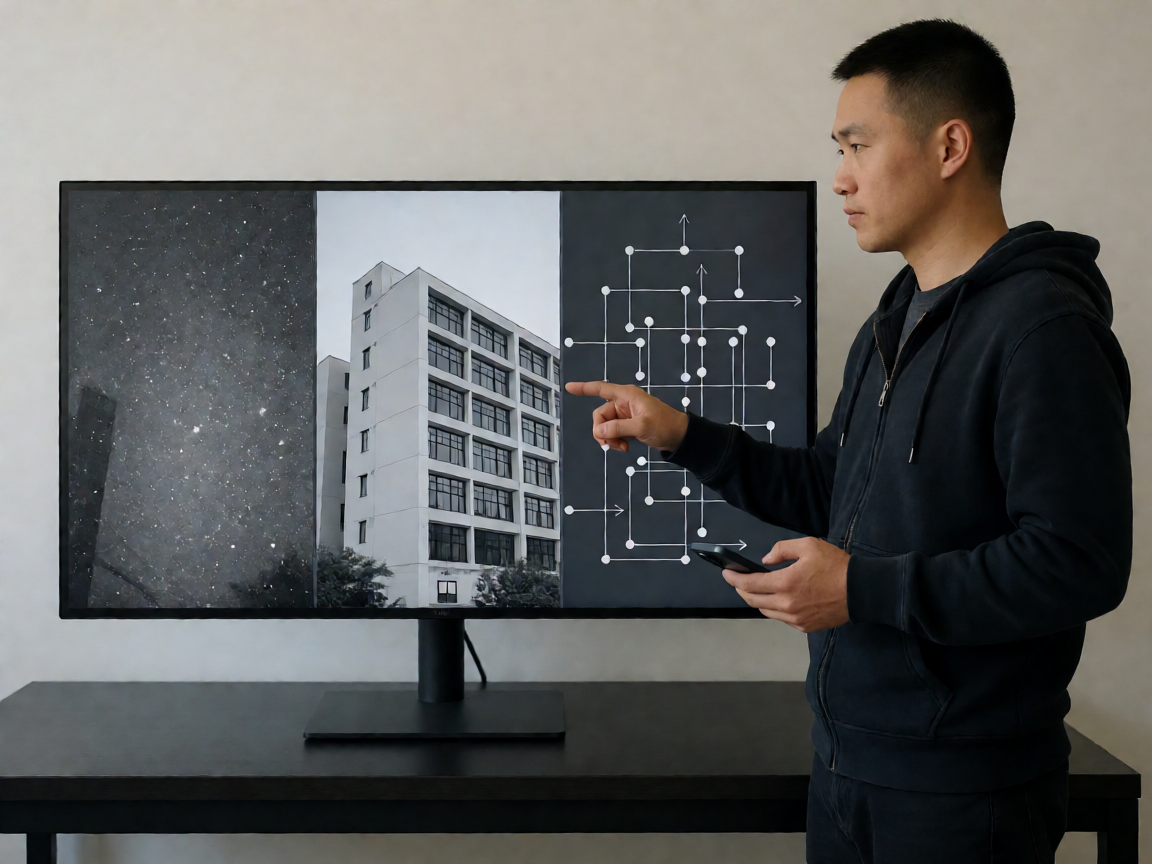
神经网络学会的是「哪些是真实细节,哪些是随机噪点」。比如建筑边缘是连续的线条,噪点则是孤立的亮点。识别出这种统计特征后,降噪算法可以有针对性地去除噪点而不损伤结构。
当前局限:AI降噪在极端低光环境下会产生「过度平滑」现象,人物皮肤质感消失,画面出现不自然的蜡状感。这是目前所有手机厂商共同面临的算法瓶颈。
深度估计:手机如何「知道」哪里该虚化
双摄立体视觉:视差原理的深度测量
手机的人像模式能拍出背景虚化效果,原理并非单一镜头模拟大光圈景深,而是通过深度估计来判断画面中每个像素距离相机的远近。
实现方式主要有两种:一种是双摄立体视觉,类似于人眼的视差原理;另一种是单摄 + AI语义分割,通过识别画面中的主体(人脸、人体)来推断景深关系。
立体视觉方案的精度取决于两颗摄像头之间的距离(基线长度)。手机双摄间距很小,导致远景深度估算误差较大——远处背景可能虚化不够,近处物体又可能虚化过度。
单摄+AI方案:语义分割的弱点
单摄+AI方案的弱点在于:当主体与背景颜色或纹理相似时,语义分割容易出错,比如头发丝与背景融合区域会出现奇怪的抠图边缘。
为解决这一问题,部分算法引入边缘细化网络,通过对前景轮廓进行亚像素级精修来改善发丝、半透明物体等复杂边界的虚化效果。
LiDAR方案:毫米级精度与功耗的权衡
进阶方案:部分高端机型引入了LiDAR扫描仪,通过发射不可见激光并测量反射时间来计算深度。精度达到毫米级,比纯视觉方案在弱光下更可靠,但功耗和成本也随之增加。

计算变焦:没有长焦镜头如何放大画面
两步流程:几何裁剪与AI超分辨率
很多手机宣称拥有「10倍变焦」甚至更高,但这并非传统光学变焦。光学变焦依赖镜组物理移动,体积受限,手机难以实现高倍率。
计算变焦的本质是:先用高分辨率传感器拍摄,再通过AI超分算法对裁剪区域进行智能放大和细节重建。
这个过程分为两步:第一步是几何裁剪,相当于放大画面的一部分;第二步是AI超分辨率,用已训练的神经网络「想象」出被裁剪掉的细节。
计算变焦与光学变焦的真实差距
超分算法的训练数据来自高分辨率实景照片,网络学会了常见纹理(如砖墙、树叶、文字)的典型结构。放大时,算法会在合理范围内「补充」这些结构。
真实差距:计算变焦无法还原光学变焦的信息完整性。当放大倍数超过传感器物理像素的合理裁切范围后,AI补出的细节其实是「推测」,在文本、车牌等精细内容上容易出现扭曲或重复纹理。
夜景模式:长曝光的算法化解决方案
手持夜景的核心挑战与突破
手机夜景模式的核心思路与HDR相似:通过多帧叠加来提升信噪比,相当于在极短时间内模拟单反的长曝光效果。
但手机没有三脚架,手持抖动是最大挑战。现代夜景算法的突破在于「电子防抖 + 帧对齐」技术。
传感器在每次曝光时记录的不仅是光信号,还有微小的位移信息(通过陀螺仪和加速计获取)。算法利用这些信息对每一帧进行亚像素级的空间对齐,然后再叠加。
帧数叠加的实用指南
叠加的帧数越多,噪点越低,但处理时间也越长。目前主流旗舰机的夜景模式最多可叠加50帧以上,处理时间约1至3秒。
- 最佳手持姿势:按住手机静止1-2秒,避免呼吸和心跳引起的微震
- 建议场景:静态夜景、建筑灯光、星空等无移动物体的场景效果最佳
- 注意事项:动态场景(有人走动、车辆经过)建议切换至专业模式手动控制
视频帧抽样的新趋势
技术趋势:部分厂商已开始尝试将视频帧用于静态夜景拍摄——即在录制视频过程中抽取多帧进行夜景合成,这样既能获得更长的有效曝光时间,又能利用视频流的连续帧信息提升对齐精度。
当前计算摄影的技术边界在哪里
动态场景限制:运动物体会破坏对齐
尽管计算摄影已取得显著进展,但它并非万能。理解其边界,有助于消费者做出更理性的判断。

首先是动态场景的限制。HDR和多帧合成都假设场景在曝光期间是静止的。当画面中有快速移动的物体(奔跑的人、行驶的车辆),对齐算法可能失效,产生重影或模糊区域。
算法幻觉:AI可能生成不存在的细节
其次是算法幻觉问题。AI降噪和超分本质上是在「猜测」缺失的信息。对于真实存在的细节,算法处理得当;但对于不存在的细节,算法可能会生成看似合理但与实际不符的内容——比如凭空产生不存在的纹理或线条。
色彩科学的主观性:没有绝对的对错
最后是色彩科学的主观性。不同手机品牌的算法调校风格差异巨大:有的偏暖,有的偏冷;有的饱和度高,有的追求还原。这没有绝对的对错,但消费者往往会因习惯了某一品牌的色彩风格而对其他品牌产生误判。
重要提醒:计算摄影的「真实」是一个相对概念。AI增强后的照片是否还代表「真实场景」,在专业摄影领域存在持续争议。对于需要精确记录的场景(新闻、证据),建议同时保存未经算法处理的RAW文件。
行动建议:RAW文件的重要性
对于追求画质上限的用户,强烈建议在拍摄时开启RAW格式。RAW文件记录了传感器原始数据,为后期处理保留最大空间,且不受机内算法的不可逆处理影响。
未来计算摄影的下一个方向是什么
计算摄影的下一步演进,预计将在以下几个方向展开:
- 端侧AI算力提升:手机SoC的NPU算力将持续增长,允许更复杂的模型在本地运行,减少云端依赖,提升隐私保护和响应速度。
- 多模态融合:除了可见光传感器,手机正在整合更多类型的传感器——热成像、深度相机、光谱传感器,每种传感器提供不同的信息维度。
- 真实感渲染:算法将从「让照片看起来好看」转向「让照片看起来真实」,减少过度锐化和涂抹感,保留自然的画面质感。
- 用户可控的计算参数:目前大多数计算摄影参数由系统自动决定,未来可能提供更多手工调节选项,让专业用户能精细控制每帧的曝光、降噪强度和虚化程度。
结论:计算摄影的本质是用算法交换物理限制。它让手机在有限体积内达到了接近专业设备的成像质量,但也带来了算法幻觉、动态场景局限等问题。理解其原理,有助于我们更理性地使用手机摄影,也帮助行业找到硬件与算法的最优平衡点。
以实际结果为准,操作前请核对官网版本、授权和安全提示。
欢迎留下你的观点,成为第一个参与讨论的人。