
Chiplet通过异构封装将多颗小Die整合为高性能SoC,以更低成本突破摩尔定律瓶颈。本文详解互连方案性能对比、技术成熟度评估框架与量产实施路径,附AMD/Intel/Apple真实案例。
单片大芯片走到尽头,设计师开始拆分
过去二十年,芯片行业依靠摩尔定律持续增长:晶体管密度翻倍,性能随之提升。但进入2020年代后,单片Die面积已逼近物理极限。面积越大,晶圆上能切出的芯片数越少,良率呈指数下降。一块2000mm²的处理器,在7nm工艺下可能只有不足50%的成品率,而同样性能用三块小Die拼起来,良率可能超过80%。这个经济学账,是Chiplet诞生的根本原因。
Chiplet到底是什么:不是新概念,是新做法
Chiplet的中文常译作「小芯片」,核心思路是把一块完整的大SoC拆成若干功能模块,每个模块单独制造成Die,再通过先进封装技术集成在一个封装体内。与传统的Monolithic设计相比,它的关键变化不在电路设计,而在封装层级。
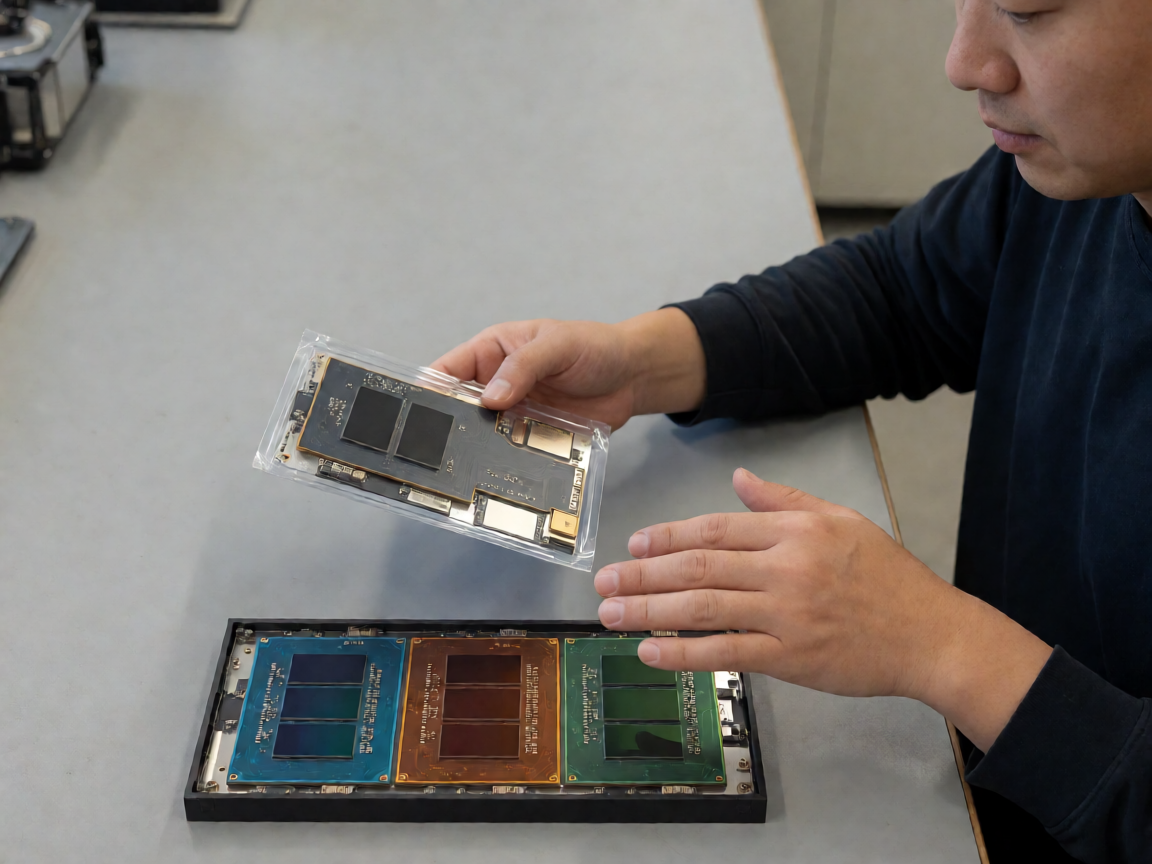
Monolithic SoC:所有模块在单一晶圆上流片,共享同一工艺节点。
Chiplet SoC:各模块可分别选用最优工艺,通过封装内互联最终整合。
这一区分很重要:Chiplet不是单纯缩小芯片尺寸,而是让不同功能的模块能用不同成熟度的工艺分别生产,再在封装环节拼接。GPU算力核心可以用最新节点,模拟IP或IO模块用成熟节点,互连带宽需求高的部分用特殊封装工艺补齐。
互连是核心:Die之间怎么「对话」
拆分成小芯片后,最大的技术挑战是Die之间的信号传递。传统封装里,所有模块在同一个硅片上,走线短且延迟极低。拆分后,模块间需要通过封装基板或中介层建立物理连接,这条通路的带宽和延迟直接决定整体性能。
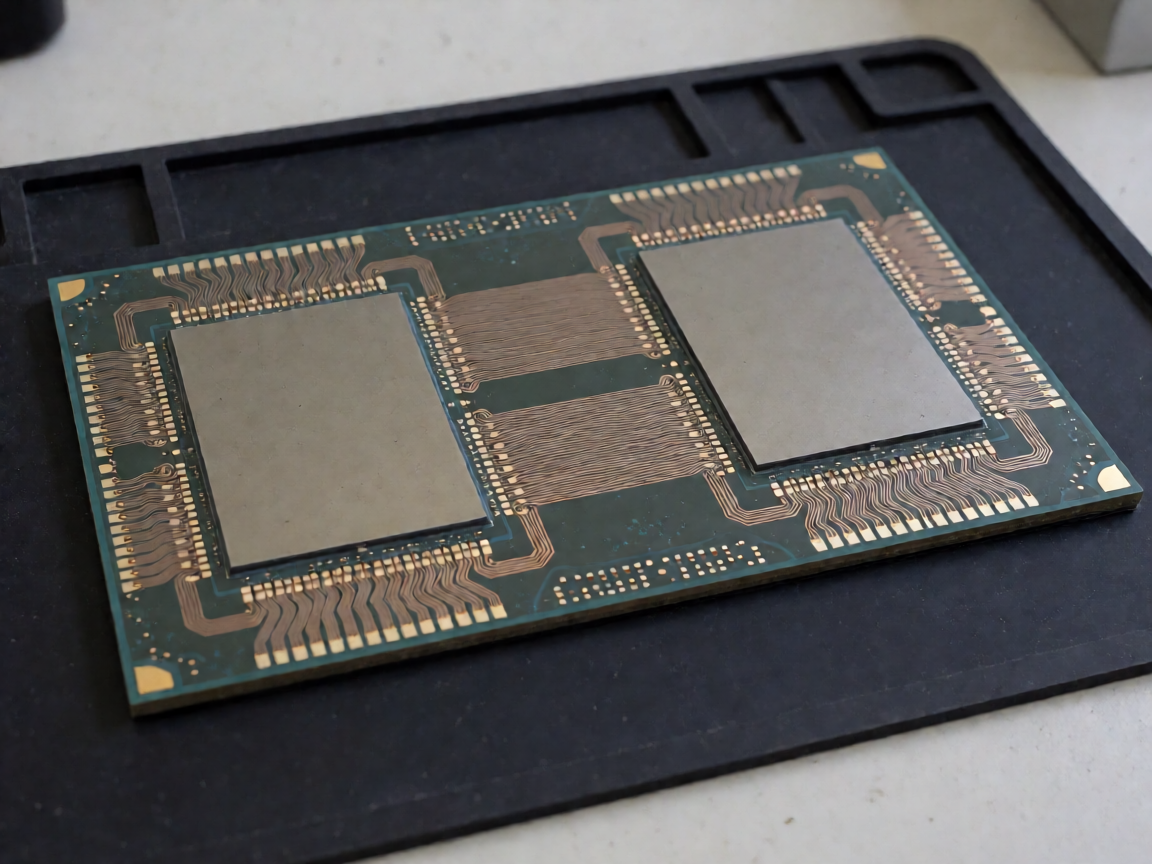
主流Die-to-Die互连路径
- 有机基板线端:成本最低,适合低频IO模块互联,延迟约纳秒级。
- 硅中介层(Interposer):TSMC CoWoS采用,布线密度高,带宽可达TB/s级。
- 硅桥(Silicon Bridge):Intel EMIB方案,只在互联区域嵌入一小片硅,其他区域仍用有机基板,成本介于两者之间。
- 裸片键合(Die-on-Wafer / Die-on-Die):将小Die直接堆叠在主Die或基板上,用微凸点或铜柱连接,适合HBM等存储堆叠。
各方案性能对比
不同互连方案在延迟和带宽上差异显著,选型时需要根据模块特性匹配:
- 有机基板:线宽/线距约3-5μm,带宽约10-50Gb/s/mm,延迟50-100ps/mm,成本基准1x。
- 硅中介层:线宽/线距可达亚微米级,带宽可达1-5TB/s/封装,延迟5-10ps/mm,成本约3-5x有机基板。
- 硅桥:带宽约200-500Gb/s/mm,延迟约10ps/mm,成本约2-3x有机基板。
- 铜柱键合:用于HBM堆叠,带宽可达4-8TB/s,延迟微秒级(存储访问),成本约4-6x。
这一差异的根本原因在于信号传播介质——有机材料的介电常数远高于硅,信号在有机基板中传播速度约为光速的40-50%,而在硅中介层中接近光速的60-70%。
标准化进展
近年来,UCIe(Universal Chiplet Interconnect Express)联盟推动的开放标准正在成为行业共识。UCIe定义了物理层和协议层规范,目标是让不同厂商的Die可以在同一封装内互操作,类似于芯片界的USB标准。目前已有NVIDIA、Intel、AMD、Samsung等参与。2024年UCIe 2.0标准发布,支持速率提升至64GT/s,并新增对以太网物理层的定义,进一步扩展了互连场景。
产业案例:谁在用,用得怎样
Chiplet不是实验室概念,已进入商业化产品并持续迭代。以下三个案例代表了当前最主流的三种路径。
AMD:Zen架构的完整Chiplet化
AMD自Zen 3时代起,将CPU核心Die、IO Die和缓存Die完全拆分。Zen 4的EPYC处理器采用7nm CCDie(核心)+ 6nm IODie的组合,通过Infinity Fabric互联。这种架构使AMD能够在不改变核心设计的情况下,灵活调整IO Die的制程,并实现单封装容纳96个核心的规模。
AMD MI300系列AI加速器采用MCM(Multi-Chip Module)架构,含一个120mm²的GPU Core Die和8个666mm²的HBM3堆叠Die,整体面积超过同代单片GPU,但良率和开发效率显著改善。
Intel:EMIB与Foveros双线并行
Intel的EMIB(Embedded Multi-Die Interconnect Bridge)技术用于data com产品如Sierra Forest处理器,在有机基板上嵌入小型硅桥连接不同Die。Foveros则面向图形和高性能计算,采用3D堆叠方式将逻辑Die直接堆在基板上,并预留接口用于第二层堆叠。
TSMC:CoWoS成为行业基础设施
TSMC的CoWoS(Chip-on-Wafer-on-Substrate)不是一种芯片设计,而是一种封装服务。它作为Foundry模式下的标准能力,被AMD、NVIDIA、Apple等客户广泛采用。随着AI芯片需求激增,CoWoS产能成为制约高端GPU交付的关键瓶颈之一。2024年TSMC宣布将CoWoS产能扩充至每月15万片等效晶圆,但仍无法满足英伟达Blackwell等旗舰产品的全部需求。
成熟度评估:不同路径的技术就绪程度
评估一项Chiplet技术是否已具备量产条件,需要综合考察工艺成熟度、验证覆盖度和生态兼容性三个维度。
已量产的成熟方案
- AMD EPYC 9004系列(Zen 4):采用2颗CCDie + 1颗IODie架构,单封装算力达每插槽96核,2023年量产,良率稳定在90%以上。
- Apple M1 Ultra / M2 Ultra:通过UCIe标准将两颗M1/M2 Die互联,集成度极高,良率验证充分。
- TSMC CoWoS-R(Ribbon型):支持2.5D堆叠的标准化封装平台,已有十余款商用芯片通过验证。
仍在演进中的方案
- Intel Foveros Direct:3D堆叠第二代,已用于Granite Rapids处理器,但良率控制仍在优化中。
- Samsung I-Cube:对标CoWoS的平台,已导入部分客户设计,但产能规模有限。
- UCIe跨厂商互操作:单厂商内部已验证,跨公司Die的互操作仍需时间积累。
选择建议
对于初创芯片公司,建议优先选择已有量产验证的封装平台(如CoWoS),而非自研封装架构。自研方案通常需要2-3年工程周期,且初期良率爬坡风险较高。
对产业格局的重塑
Chiplet正在改变半导体行业的权力结构,影响至少三个维度。
设计上:传统「全栈自研」模式被打破。一家公司可以购买第三方IP Die(如AI加速核心或高速SerDes),与自己设计的计算Die集成,相当于在封装层面实现了「芯片级并购」。
制造上:Fab的角色从「按图制造完整芯片」转向「提供多种工艺节点的Die制造 + 封装服务」。TSMC、Samsung、Intel Foundry都在竞争同一市场,封装能力成为新的护城河。
设计工具上:传统EDA工具针对单片设计优化,Chiplet需要支持跨Die的信号完整性分析、热仿真和时序收敛,这对Synopsys、Cadence、Siemens EDA都是新挑战。
限制与风险:拆开后不是万事大吉
Chiplet的优势明显,但也带来新的工程风险,主要体现在四个方面。
良率重新分布:单片Die良率高但面积大,Chiplet拆分后单Die良率提升,但封装良率成为新变量。多层堆叠和细间距互连对工艺控制要求极高。
性能损耗:Die间互联的延迟和带宽通常不如同片硅上的走线。即使采用硅桥或中介层,信号穿越封装界面的损耗仍存在,设计时需要精确建模以避免性能超预期下降。
测试难度:单片芯片可以在封装前做Final Test,Chiplet需要在封装后测试整体功能。不良Die一旦封装就无法挽回,因此「Known Good Die」(KGD)评估变得至关重要。
热管理:多层堆叠导致热量在垂直方向堆积,顶层Die可能面临散热瓶颈。这限制了3D Chiplet的堆叠层数和功率密度。
实施路径:从概念到量产的四个阶段
将Chiplet方案从设计推向量产,需要依次完成以下四个阶段,每个阶段的验证重点不同。
阶段一:架构定义(D1-D2月)
明确拆分边界和互连方案。核心判断标准是:拆分后模块间的通信频率是否足够低,使得封装互联的延迟代价可接受。建议优先拆分「IO模块」和「存储控制器」,避免拆分「核心计算单元」之间的互联。
阶段二:Die设计与验证(D3-D6月)
每个Die独立进行前端设计、布局布线、signoff验证。此阶段需确保各Die满足接口协议要求(如UCIe物理层参数),并进行跨Die的时序收敛分析。关键交付物是GDSII文件和KGD测试向量。
阶段三:封装集成(D7-D9月)
Die通过先进封装工艺集成。需要重点关注:热仿真(确保最高功耗Die的结温不超过105°C)、应力分析(多层堆叠的翘曲控制)、以及封装后的电气参数(插入损耗、回波损耗)。建议引入第三方封装厂的DFM(可制造性设计)评审。
阶段四:系统级验证(D10-D12月)
封装完成后,进行系统级功能测试、性能benchmark、热测试和可靠性测试(HTOL、温循等)。建议设计可观测性机制(如DFT内置)以支持故障定位。
常见陷阱与规避方法
- 忽略KGD测试覆盖率:KGD测试应覆盖所有逻辑功能和关键时序,建议覆盖度≥99%。
- 热设计未分层考虑:每层Die的功率密度需单独建模,顶层需预留20-30%散热余量。
- 接口协议过于定制:优先采用UCIe等开放标准,避免私有协议导致未来升级困难。
- 低估验证复杂度:Chiplet系统的验证工作量通常是单片芯片的1.5-2倍,需提前规划验证资源。
接下来值得关注什么
Chiplet赛道仍在快速演进,以下几件事值得持续观察。
- UCIe商业化落地:标准已发布,但不同厂商Die的互操作仍需时间验证。首个跨公司UCIe认证产品何时出现是关键节点。
- 国产封装产能:中国半导体企业在CoWoS类先进封装领域的布局进度,直接影响本土AI芯片的交付能力。
- 液冷与Chiplet的结合:AI芯片功耗突破1000W后,封装级的热设计成为独立课题,Chiplet的模块化结构或许能为液冷散热提供更灵活的设计空间。
- Chiplet之外的演进:光互联Die-to-Die、异构集成中的存算一体Die,可能是下一个突破方向。
总结
Chiplet的本质是用封装工程替代部分设计工程——把原本需要一次流片解决的性能和良率问题,分解到多个Die和封装工艺中逐一攻克。它不是对摩尔定律的否定,而是对后摩尔时代增长路径的一次重构。短期看,它是高端芯片走向量产的现实选择;长期看,它可能推动半导体行业从「设计驱动」转向「系统级整合驱动」,封装和互联的能力,将越来越等同于曾经的设计能力。
以实际结果为准,操作前请核对官网版本、授权和安全提示。
欢迎留下你的观点,成为第一个参与讨论的人。