
面对AI算力需求激增,传统冯架构正遭遇能效比瓶颈。本文深度解析神经形态计算的核心机制,分析如何通过脉冲神经网络实现低功耗计算,并探讨其在边缘计算与自动驾驶领域的真实应用前景。
核心结论
神经形态计算(Neuromorphic Computing)通过模拟生物大脑的神经元与突触结构,从根本上缓解了传统冯·诺曼架构中存储与计算分离导致的”内存墙”问题。在处理稀疏时序数据时,其能效比可高出传统GPU数个数量级,是下一代边缘AI与实时感知系统的核心技术路径之一。
技术背景:算力增长的”天花板”
长期以来,几乎所有数字计算机都运行在冯·诺曼架构之上,即处理器与内存在物理上相互独立。随着深度学习模型参数向万亿规模增长,数据在处理器与内存之间频繁搬运所产生的能耗与延迟,已远超算术运算本身。
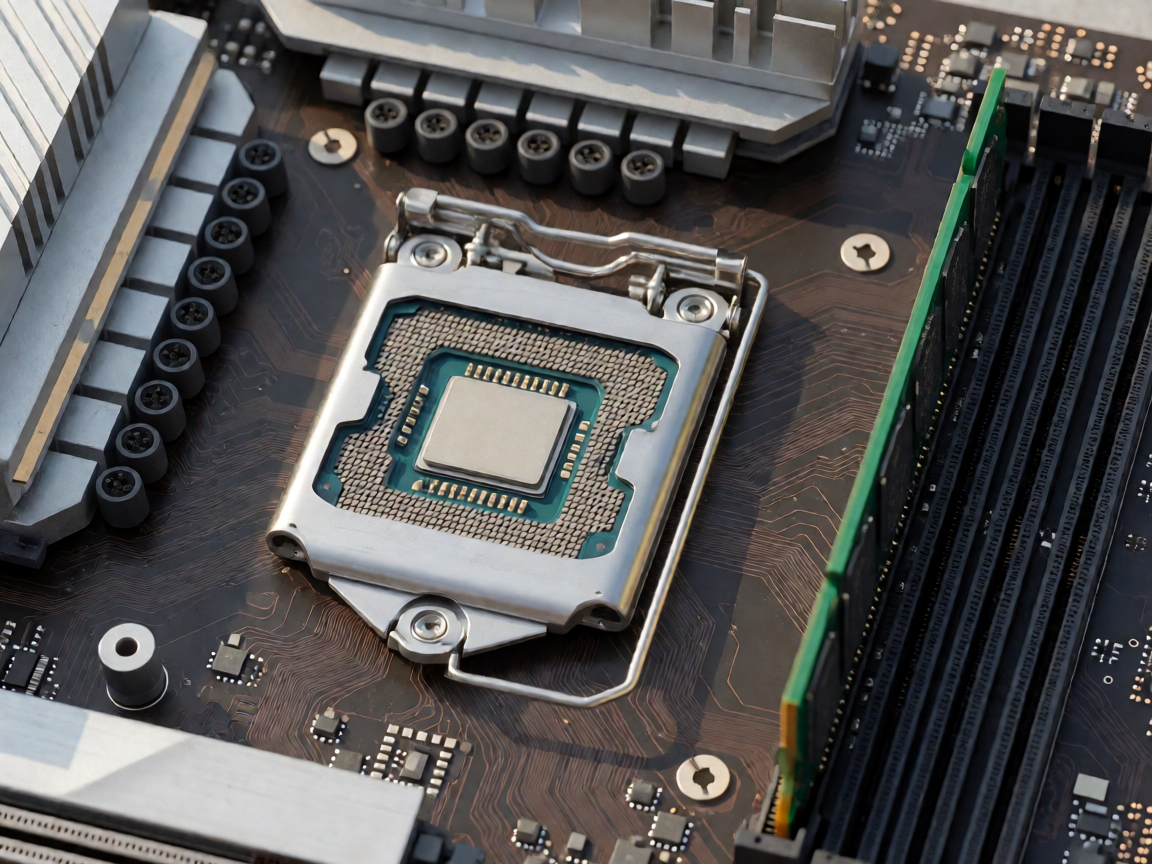
在当代SoC设计中,片上数据搬移(从L2/L3缓存或DRAM到执行单元)通常占总能耗的70%以上,而实际逻辑运算占比不足10%。这一不对称比例构成了所谓的”内存墙”,也是摩尔定律红利收窄后最先触及的物理极限。
人类大脑功耗仅约20瓦,却能完成复杂的多模态感知与决策。这种极端能效对比促使科研界转向更接近生物逻辑的计算范式:将存储功能直接集成进计算单元,消除数据在总线上的长距离搬运,从而在架构层面打破上述能耗分配失衡。
原理与关键机制:脉冲神经网络与存算一体
神经形态计算的核心载体是脉冲神经网络(SNN)。与传统深度网络输出连续浮点激活值不同,SNN中的神经元仅在输入膜电位超过阈值时发出一个离散脉冲(spike),空闲期间电路处于亚阈值态,静态功耗极低。
这种”事件驱动”特性使计算量与输入信息的时空稀疏度直接成正比——输入越稀疏,实际执行的门操作越少。同时,突触权重以忆阻器或RRAM器件的形式物理驻留在神经元旁侧,读写操作与信号传播在同一物理位置完成,实现真正的存算一体。
核心技术特征对比
- 事件驱动:仅在有脉冲到达时激活局部电路,无信号期间功耗趋近于零。
- 局部学习:采用STDP(突触可塑性依赖时序)等规则,根据前后脉冲的先后关系增减单条突触权重,无需全局反向传播。
- 天然并行:数万个神经元独立膜电位积分,无时钟同步约束,具备硬件级异步并行能力。
STDP的具体硬件映射是:若突触前脉冲先于突触后脉冲到达,则权重增量Δw正(长时程增强);反之Δw负(长时程抑制)。该规则仅需记录最近两个脉冲的时间戳差值,无需维护完整激活历史,因此对存储容量的要求远低于梯度下降。
实际应用案例:从机器人感知到自动驾驶
在视觉感知领域,传统相机以固定帧率(如30fps)整帧输出所有像素值,即使场景静止也持续产生全量数据。而搭配神经形态芯片的事件相机(如DVS阵列)仅记录单个像素亮度发生显著变化的时空坐标,数据量可降低一至两个数量级,响应延迟缩短至亚毫秒级。
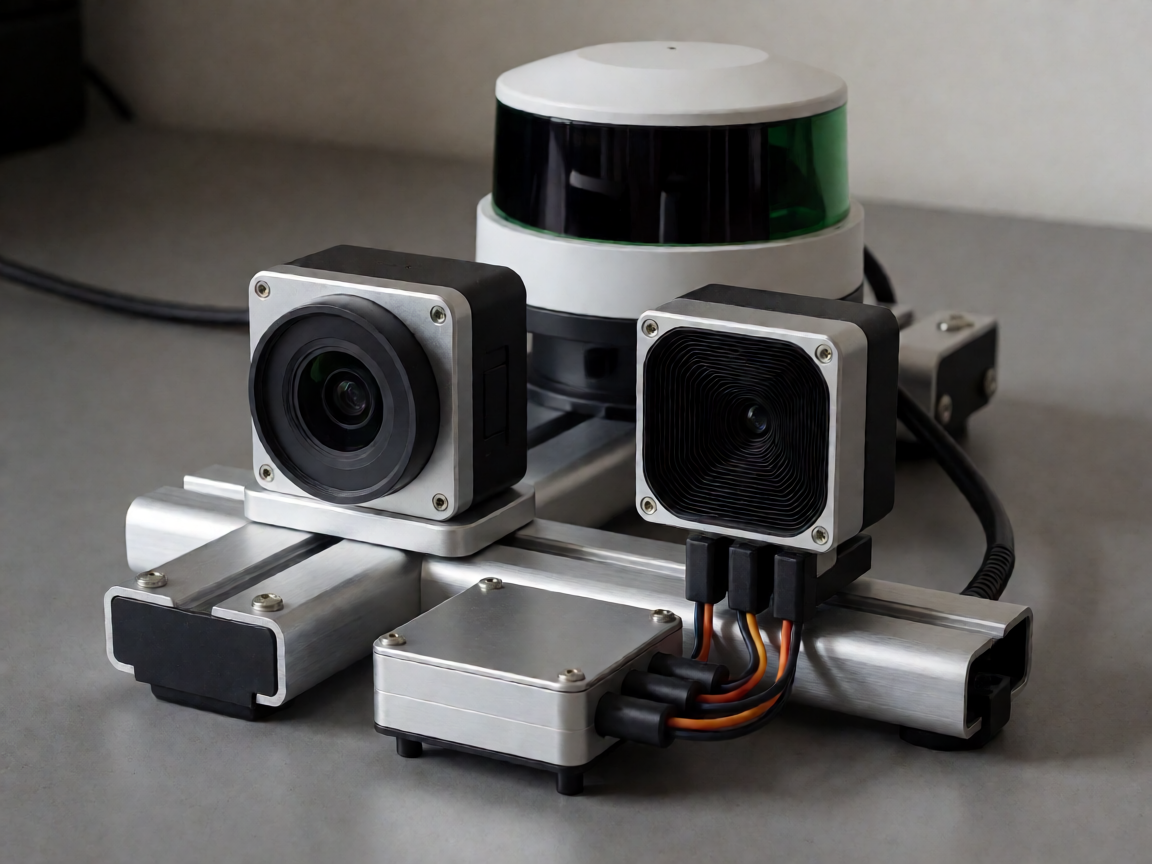
在自动驾驶场景中,神经形态处理器可在车端实时融合激光雷达点云与事件流,在本地完成障碍物检测与轨迹预测,无需将原始传感数据上传云端。这不仅规避了通信链路延迟与带宽瓶颈,也显著降低了车载计算平台的散热设计与功耗预算。
适用场景判断条件
- 时空稀疏度:输入信号中有效脉冲占比低于10%–20%(如慢速运动场景、静态背景下的微动检测)。
- 延迟约束:端到端响应需控制在10 ms以内,超出传统CPU+GPU流水线的硬实时窗口。
- 功耗预算:可用功率小于5 W,且无法依赖周期性充电(如植入式传感器、太阳能微节点)。
产业影响:重塑边缘计算格局
神经形态计算的成熟将把AI推理从”云端集中智能”推向”全场景分布式智能”。物联网终端、可穿戴设备与工业机器人不再依赖稳定云连接即可在极低电量下完成模式识别与闭环控制,网络可用性不再是功能前提。
对芯片设计行业而言,这意味着设计范式发生根本转变:核心优化目标从提升主频与缓存命中率,转向设计高效的脉冲编码方案、拓扑连接策略与新型存算器件的协同布局,将引发半导体EDA工具链与工艺节点的新一轮调整。
局限、风险与争议
最突出的挑战在于SNN训练算法的成熟度仍低于深度学习的反向传播体系。在静态图像分类等高密度、低稀疏度的任务上,SNN的精度通常落后于同等参数量的CNN或Transformer模型;同时,训练收敛所需迭代次数与硬件仿真开销仍是工业落地的主要瓶颈。
此外,开发工具链的缺失加剧了异构性成本。目前尚无与PyTorch或JAX同等成熟的通用编程框架,现有模型向神经形态硬件迁移需手动重设计脉冲编码与层映射策略,软件生态断层限制了短期商业化节奏。
不适用场景与工程限制
- 高密度静态特征提取(如高分辨率医学影像分割),因输入稀疏度不足,SNN相对优势消失。
- 需要大规模批量在线学习与快速权重更新的数据中心训练场景,STDP局部更新效率远低于矩阵化梯度下降。
- 对数值精度要求极高的浮点密集运算(如科学仿真),脉冲编码的有限位宽会引入不可忽略的量化误差。
后续关注点
未来值得重点跟踪两个技术方向:一是混合架构的工程化落地,即在同一SoC内集成传统ALU与脉冲加速单元,让高精度推理与低功耗实时感知各取所长;二是RRAM等新型非易失存储器在神经形态芯片中的面积集成密度与写耐久性(write endurance)指标,这直接决定存算一体单元的寿命与可扩展上限。
观察指标建议关注:SNN在标准时序基准(如SHD-DB手势数据集)上与最优CNN的精度差距是否收窄至2个百分点以内;以及商用事件相机出货量与配套脉冲SoC的片上存储密度(每mm³突触容量)的季度变化。
总结
神经形态计算并非对通用计算的全面替代,而是面向高稀疏、强实时、低功耗场景的架构级解法。它以脉冲编码与存算一体为核心,直击内存墙的能耗根源。当前短板集中在训练生态与通用工具链,但随着边缘侧感知需求持续膨胀与新型器件工艺迭代,它将在未来十年成为底层算力版图的关键增量。行动建议:工程团队在架构选型阶段,可先用事件相机+边缘FPGA原型验证自身场景的脉冲稀疏度,再决定是否投入类脑硬件设计。
以实际结果为准,操作前请核对官网版本、授权和安全提示。
欢迎留下你的观点,成为第一个参与讨论的人。