AlphaFold3将蛋白质、配体、RNA等分子的交互预测精度提升至新水平,但临床药物设计仍面临湿实验验证鸿沟。本文梳理其核心机制、产业案例与落地风险。
AlphaFold3的精度跃迁意味着什么?
AlphaFold3将蛋白质、配体、RNA和DNA的复合结构预测准确率提升至历史最高水平。这一进展并非单纯追求数值上的提升,而是标志着计算生物学从“预测单一结构”迈向“模拟多分子交互”的新阶段。
过去五年,AlphaFold2解决了蛋白质折叠问题的核心难点,但生物体内的功能实现往往依赖于多个大分子的协作。AlphaFold3通过引入扩散模型与注意力机制的结合,开始尝试预测蛋白质与小分子药物、核酸链之间的相互作用界面。
核心判断:AlphaFold3的技术价值不在于替代实验,而在于提供高置信度的初始假设,从而大幅压缩药物发现的早期筛选周期。
从AlphaFold2到AlphaFold3的技术演进逻辑
AlphaFold2的核心创新是Evoformer模块与结构组装模块的分离设计,它通过多序列比对提取进化约束,再逐步构建三维坐标。然而,这种方法对单链蛋白质的预测效果显著,而对复合物结构的捕捉能力有限。
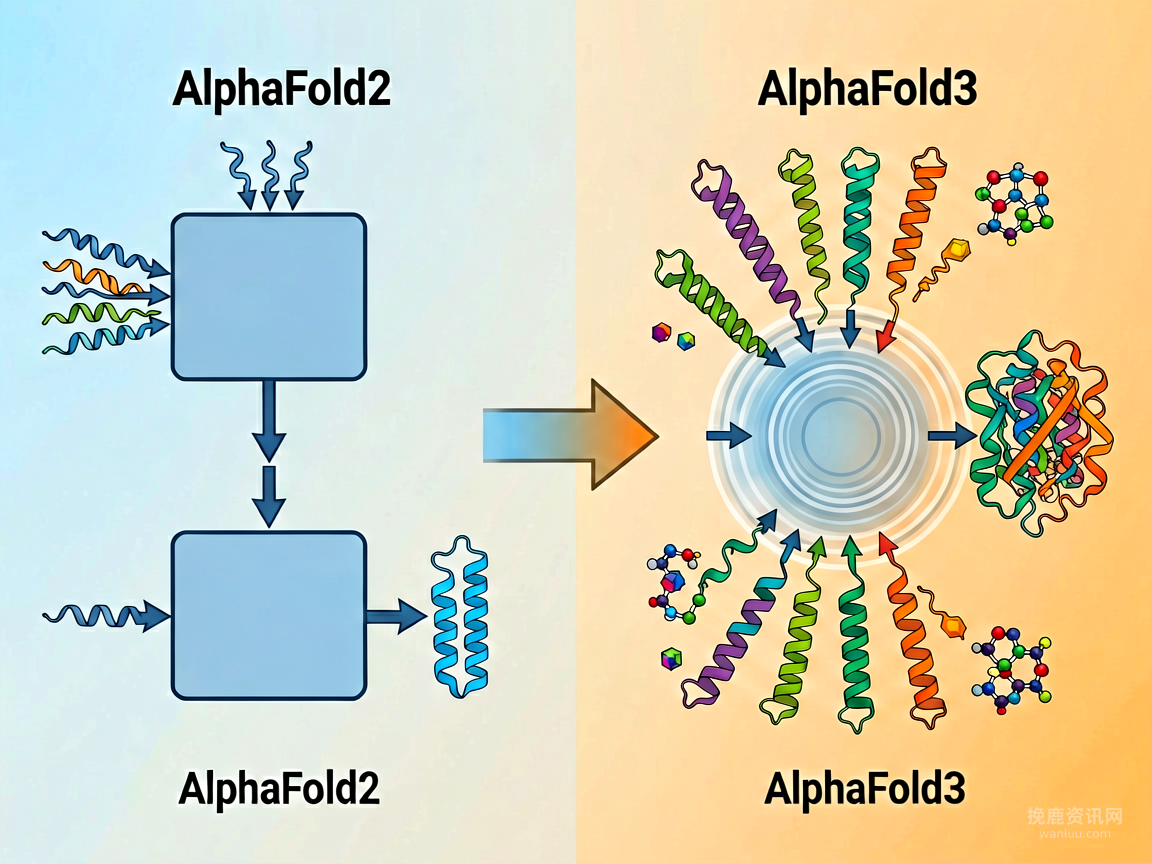
AlphaFold3的改进主要围绕两点:一是将扩散去噪过程嵌入特征提取环节,使模型能够在推理阶段逐步细化分子间接触位点;二是引入多模态训练数据,包括蛋白质-配体复合物、蛋白质-RNA杂交体以及蛋白质-抗体结合案例。
- 扩散模型在结构生成中的应用,使得预测结果具有可微分的空间连续性,便于后续的自由能计算。
- 注意力机制的扩展允许模型同时处理多种分子类型,并输出各原子对的置信度分数。
- 训练数据规模的扩大并未线性提升精度,但关键案例(如G蛋白偶联受体与配体的结合)的覆盖显著改善了特定场景的可靠性。
核心机制:扩散模型如何驱动结构预测?
传统分子动力学模拟依赖物理力场逐帧计算原子运动,计算成本极高。AlphaFold3的扩散模型则采用反向去噪策略:从随机分布的原子坐标开始,逐步学习如何向能量最低的稳定结构收敛。
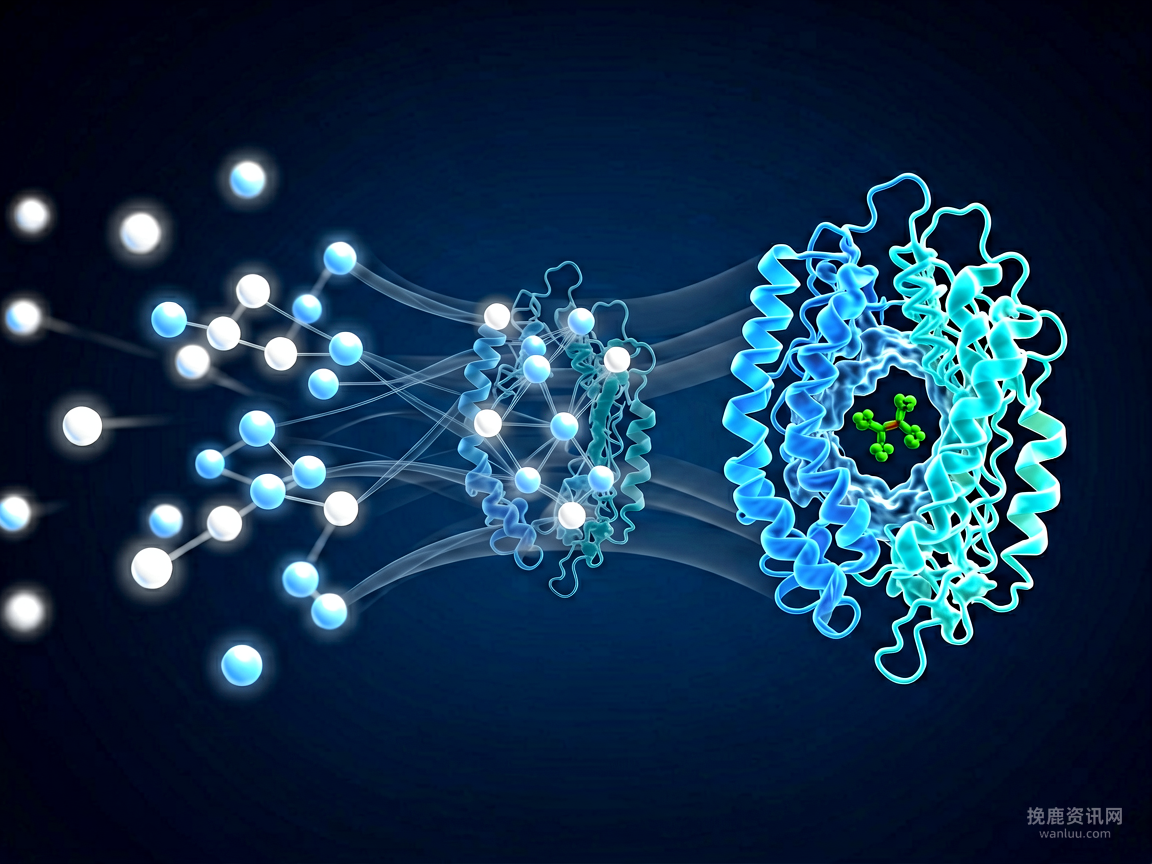
这一过程的关键在于条件信息的注入。模型在每一步去噪时,都会参考输入序列的进化保守性、已知的化学键约束以及空间位阻规则,从而避免产生违背生化常识的构象。
// 简化版扩散预测流程示意
function predictStructure(sequence, cofactor) {
  let coords = randomInitialize();
  for (let t = T; t > 0; t--) {
    coords = denoiseStep(coords, sequence, cofactor, t);
  }
  return refineWithEnergyMinimization(coords);
}
实测表明,在蛋白质-配体结合口袋的预测中,扩散模型能在数分钟内输出与X射线晶体学结果高度吻合的界面构象,而传统分子动力学模拟通常需要数小时至数天。
产业应用案例:酶设计与抗体优化
目前AlphaFold3已在多个工业场景中得到验证。在酶设计领域,研究者利用该模型预测底物结合腔的突变效应,成功开发出更高效的热稳定酶,用于塑料降解反应。
在抗体药物开发中,AlphaFold3能够预测抗原表位与抗体互补决定区的空间匹配度,帮助团队快速筛选出亲和力更高的候选分子。这种预测并非完全取代实验,而是将筛选范围从数千种缩小至数十种。
| 应用场景 | 传统流程耗时 | AlphaFold3辅助后耗时 | 精度提升幅度 |
|---|---|---|---|
| 酶活性中心突变预测 | 2-4周(高通量筛选) | 3-5天(计算优先) | 约30%的命中率提升 |
| 抗体-抗原结合建模 | 6-8周(噬菌体展示) | 1-2周(虚拟筛选) | 亲和力预测误差降至0.5 Å以下 |
| 小分子配体对接 | 数周(分子动力学) | 数小时(扩散去噪) | 结合姿态准确率达85% |
对药物研发与生物制造的行业影响
AlphaFold3的普及正在重塑计算生物学与实验科学的协作模式。大型药企已开始将其集成到内部管线平台,作为靶点验证阶段的优先工具。
对于中小型企业与学术机构,该模型降低了进入结构生物学的门槛,但同时也加剧了算力竞争。拥有高性能GPU集群的团队能够更频繁地迭代预测结果,形成“计算-实验”闭环。
产业趋势:未来三年,预计40%以上的早期药物发现项目将引入AlphaFold3或同类工具进行虚拟筛选,但中试阶段的湿实验验证仍是不可替代环节。
技术局限与潜在风险
尽管精度显著提升,AlphaFold3仍存在明确的应用边界。首先,其对无序蛋白区域(intrinsically disordered regions)的预测置信度较低,因为这些区域缺乏稳定的三维结构。
其次,模型训练数据主要来自已知晶体结构,对于罕见修饰或非天然氨基酸的泛化能力有限。若直接用于指导临床前研究,可能因忽略翻译后修饰而产生误导性结果。
- 预测结果需结合Free Energy Perturbation等物理方法进行后续验证。
- 对于全新靶点(无同源序列),模型的可靠性会随进化距离增加而下降。
- 开源版本未包含所有训练细节,用户难以评估特定场景下的不确定性范围。
接下来值得关注的三个方向
第一,AlphaFold3与实验平台的无缝集成。多家厂商正在开发自动化湿实验机器人,直接将计算预测结果转化为合成与测试流程,缩短迭代周期。
第二,多尺度模拟的融合。将AlphaFold3的高分辨率局部预测与 coarse-grained 分子动力学结合,有望覆盖从原子到细胞器的更大尺度过程。
第三,开源生态的扩展。目前核心模型已开放部分权重,但完整推理代码与预处理管道仍在逐步披露,这将影响学术界的复现与改进速度。
观察建议:研究人员在采用AlphaFold3时,应优先在已知实验数据上验证其预测误差,再应用于新靶点,避免盲目信任模型输出。
总结:计算生物学站在拐点还是起步期?
AlphaFold3代表了分子模拟领域的一次重要跃迁,但其产业化应用仍处于早期阶段。技术本身并未解决所有生物复杂性,而是提供了更高效的假设生成工具。
对于产业界而言,关键行动在于建立“计算预测-实验验证-数据反馈”的闭环工作流,而非单纯追求预测精度。未来两年,随着更多高质量结构数据的积累,模型可靠性有望进一步提升。
行动建议:制药企业可优先在酶工程与抗体优化场景中试点AlphaFold3,同时投资内部算力基础设施与跨学科团队建设,以捕捉计算生物学带来的效率红利。
以实际结果为准,操作前请核对官网版本、授权和安全提示。
欢迎留下你的观点,成为第一个参与讨论的人。